Industrial Knowledge
Thống kê mô tả là gì? Trung bình, trung vị, độ lệch chuẩn | Ví dụ tính tay
Nội dung bài viết 9 mục
Trước khi chạy kiểm định, vẽ biểu đồ kiểm soát hay tính Cpk, việc đầu tiên với bất kỳ bộ dữ liệu nào là tóm tắt nó bằng vài con số. Đó là thống kê mô tả. Làm sai bước này (ví dụ chỉ nhìn trung bình mà quên độ phân tán) là nguồn gốc của rất nhiều kết luận vội vàng trong cuộc họp chất lượng.
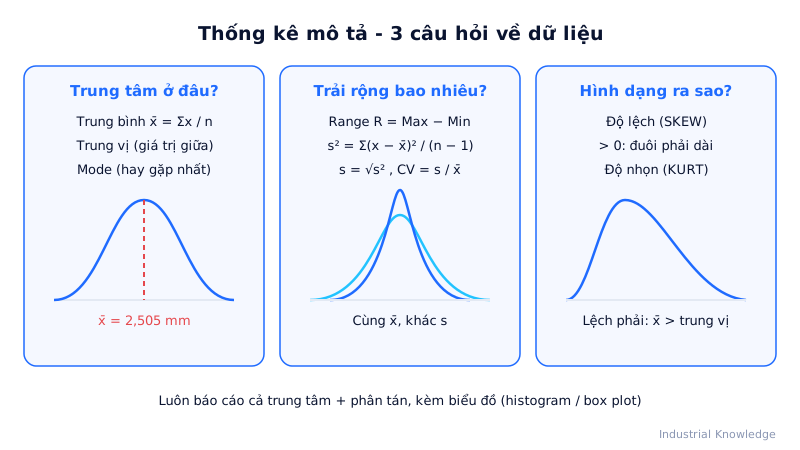
Tóm tắt nhanh
- Thống kê mô tả tóm tắt dữ liệu đã thu: tập trung ở đâu, trải rộng bao nhiêu, hình dạng phân phối ra sao.
- Chỉ số chính: trung bình, trung vị, mode; range, phương sai, độ lệch chuẩn, IQR; skewness, kurtosis.
- Tổng thể dùng ký hiệu μ, σ, N; mẫu dùng x̄, s, n – trong nhà máy gần như luôn làm với mẫu.
- Lỗi lớn: chỉ báo cáo trung bình, nhầm STDEV.P với STDEV.S, gộp nhiều máy/khuôn/ca rồi tính một độ lệch chuẩn.
Thống kê mô tả là gì?
Thống kê mô tả (descriptive statistics) là nhóm phương pháp dùng để tóm tắt, sắp xếp và trình bày dữ liệu đã thu được, không suy rộng ra ngoài mẫu. Nó trả lời ba câu hỏi:
- Dữ liệu tập trung ở đâu? – trung bình, trung vị, mode.
- Dữ liệu trải rộng bao nhiêu? – range, phương sai, độ lệch chuẩn, IQR.
- Hình dạng phân phối ra sao? – độ lệch (skewness), độ nhọn (kurtosis).
Phân biệt với thống kê suy luận (khoảng tin cậy, kiểm định giả thuyết): dùng mẫu để kết luận về tổng thể. Thống kê mô tả là nền móng; suy luận xây trên nó.
Cần nhớ ký hiệu: tổng thể dùng chữ Hy Lạp (μ, σ, N), mẫu dùng chữ Latin (x̄, s, n). Trong nhà máy, gần như lúc nào ta cũng chỉ có mẫu.
Các chỉ số và công thức
| Nhóm | Chỉ số | Công thức / cách tính | Ghi chú |
|---|---|---|---|
| Trung tâm | Trung bình x̄ | x̄ = Σxᵢ / n | Nhạy với giá trị ngoại lai |
| Trung tâm | Trung vị (median) | Giá trị giữa sau khi sắp xếp; n chẵn lấy trung bình 2 giá trị giữa | Bền vững với ngoại lai |
| Trung tâm | Mode | Giá trị xuất hiện nhiều nhất | Hữu ích với dữ liệu rời rạc, loại lỗi |
| Phân tán | Range R | R = Max − Min | Đơn giản, dùng trong biểu đồ Xbar-R |
| Phân tán | Phương sai mẫu s² | s² = Σ(xᵢ − x̄)² / (n − 1) | Đơn vị bình phương |
| Phân tán | Độ lệch chuẩn s | s = √s² | Cùng đơn vị với dữ liệu |
| Phân tán | Hệ số biến thiên CV | CV = s / x̄ × 100% | So sánh độ ổn định giữa các đặc tính khác đơn vị |
| Hình dạng | Độ lệch (skewness) | ≈ 0: đối xứng; > 0: đuôi phải dài; < 0: đuôi trái dài | Excel SKEW |
| Hình dạng | Độ nhọn (kurtosis, dạng “excess”) | ≈ 0: giống chuẩn; > 0: đỉnh nhọn, đuôi dày; < 0: dẹt | Excel KURT |
Vì sao chia cho n − 1? Vì độ lệch được tính quanh x̄ (đã “dùng” dữ liệu để ước lượng), tổng bình phương bị nhỏ hơn thực tế. Chia cho n − 1 (bậc tự do) giúp s² là ước lượng không chệch của σ². Khi n lớn, khác biệt giữa n và n − 1 không đáng kể.
Ví dụ tính tay: độ dày tấm thép (minh hoạ)
Một xưởng cán tại Bình Dương đo độ dày 8 tấm thép (mm), danh nghĩa 2,50 mm:
2,48 – 2,52 – 2,50 – 2,47 – 2,53 – 2,50 – 2,49 – 2,55
Bước 1 – Trung bình: tổng = 20,04 → x̄ = 20,04 / 8 = 2,505 mm.
Bước 2 – Trung vị và mode: sắp xếp: 2,47 – 2,48 – 2,49 – 2,50 – 2,50 – 2,52 – 2,53 – 2,55. Hai giá trị giữa là 2,50 và 2,50 → trung vị = 2,50 mm. Mode = 2,50 mm (xuất hiện 2 lần).
Bước 3 – Range: 2,55 − 2,47 = 0,08 mm.
Bước 4 – Phương sai và độ lệch chuẩn:
| xᵢ | xᵢ − x̄ | (xᵢ − x̄)² |
|---|---|---|
| 2,48 | −0,025 | 0,000625 |
| 2,52 | 0,015 | 0,000225 |
| 2,50 | −0,005 | 0,000025 |
| 2,47 | −0,035 | 0,001225 |
| 2,53 | 0,025 | 0,000625 |
| 2,50 | −0,005 | 0,000025 |
| 2,49 | −0,015 | 0,000225 |
| 2,55 | 0,045 | 0,002025 |
| Tổng | 0 | 0,005000 |
s² = 0,005 / 7 ≈ 0,000714 mm² → s = √0,000714 ≈ 0,0267 mm. CV ≈ 0,0267 / 2,505 ≈ 1,07%.
Bước 5 – Hình dạng: trung bình (2,505) lớn hơn trung vị (2,50) một chút, giá trị 2,55 kéo đuôi phải. Hàm SKEW cho kết quả khoảng 0,48 → lệch phải nhẹ. Với chỉ 8 điểm, độ lệch và độ nhọn rất không ổn định, chỉ nên coi là gợi ý.
Đọc kết quả: quá trình hơi lệch lên so với danh nghĩa (+0,005 mm), độ phân tán khoảng 0,027 mm. Nếu dung sai ±0,10 mm thì ±3s ≈ ±0,08 mm vẫn nằm trong, nhưng cần nhiều dữ liệu hơn và xác nhận quá trình ổn định trước khi tính năng lực (xem Cpk và SPC).
Đo vị trí tương đối: phân vị và Z-score
Ngoài “trung tâm” và “độ rộng”, nhiều khi ta cần biết một giá trị cụ thể đứng ở đâu so với phần còn lại:
- Phân vị thứ p (percentile): giá trị mà khoảng p% dữ liệu nhỏ hơn hoặc bằng nó. Tứ phân vị Q1, Q2 (trung vị), Q3 chính là phân vị 25, 50, 75 – nền tảng của box plot. Trong ví dụ trên, 2,53 mm có 7/8 giá trị ≤ nó, tức nằm khoảng phân vị 87,5.
- Z-score: z = (x − x̄) / s, cho biết giá trị cách trung bình bao nhiêu độ lệch chuẩn. Tấm dày 2,55 mm có z = (2,55 − 2,505) / 0,0267 ≈ 1,68 – lớn nhưng chưa tới mức bất thường. Với dữ liệu gần chuẩn, |z| > 3 là dấu hiệu cần điều tra ngoại lai.
Tóm tắt bằng bảng và biểu đồ
Con số tóm tắt luôn nên đi kèm một cách trình bày trực quan. Chọn công cụ theo loại dữ liệu:
| Loại dữ liệu | Bảng | Biểu đồ |
|---|---|---|
| Định tính (loại lỗi, ca, nhà cung cấp) | Bảng tần số, tần suất (%) | Biểu đồ cột, Pareto (cột xếp giảm dần), biểu đồ tròn khi ít nhóm |
| Định lượng (kích thước, thời gian) | Bảng tần số theo lớp, tần số tích luỹ | Histogram, dot plot, stem-and-leaf, đường tích luỹ (ogive), box plot |
Dựng bảng tần số cho dữ liệu đo: (1) chọn số lớp, thường 5–10 lớp cho vài chục điểm, nhiều hơn khi dữ liệu lớn (một quy tắc nhanh: số lớp ≈ √n); (2) độ rộng lớp ≈ (Max − Min) / số lớp, làm tròn lên số dễ đọc; (3) xác định cận các lớp sao cho không chồng nhau và phủ hết dữ liệu. Muốn đọc được hình dạng histogram một cách tin cậy nên có từ 50–100 điểm trở lên; với 8 điểm như ví dụ trên, dot plot trung thực hơn.
Đọc nhanh hình dạng histogram – mỗi dạng gợi ý một câu chuyện ở xưởng:
| Hình dạng | Gợi ý nguyên nhân |
|---|---|
| Chuông, một đỉnh, đối xứng | Quá trình chịu nhiều nguồn biến động nhỏ, ngẫu nhiên |
| Lệch một phía | Có giới hạn vật lý (độ nhám, thời gian ≥ 0) hoặc người vận hành chỉnh “né” một phía dung sai |
| Hai đỉnh / nhiều đỉnh | Trộn dữ liệu từ 2+ máy, khuôn, ca, lô nguyên liệu → phân tầng lại |
| Bị “cắt cụt” một hoặc hai đầu | Đã có sàng lọc/kiểm 100% loại bỏ hàng ngoài dung sai |
| Một cột cao bất thường ở mép | Giá trị ngoài dung sai bị ghi “dồn” vào sát giới hạn, hoặc lỗi ghi chép |
| Răng lược (cột cao thấp xen kẽ) | Độ phân giải thiết bị đo kém hoặc thói quen làm tròn số |
Làm trong Excel và Minitab
Excel (dữ liệu ở A2:A9):
| Chỉ số | Hàm |
|---|---|
| Trung bình | =AVERAGE(A2:A9) |
| Trung vị | =MEDIAN(A2:A9) |
| Mode | =MODE.SNGL(A2:A9) (nhiều mode: MODE.MULT) |
| Range | =MAX(A2:A9)-MIN(A2:A9) |
| Phương sai mẫu | =VAR.S(A2:A9) (tổng thể: VAR.P) |
| Độ lệch chuẩn mẫu | =STDEV.S(A2:A9) (tổng thể: STDEV.P) |
| Độ lệch / độ nhọn | =SKEW(A2:A9) / =KURT(A2:A9) |
| Tứ phân vị | =QUARTILE.EXC(A2:A9;1) |
Hoặc bật Analysis ToolPak: Data → Data Analysis → Descriptive Statistics, tick Summary statistics.
Minitab: Stat → Basic Statistics → Display Descriptive Statistics, chọn cột, bấm Statistics… để chọn thêm Skewness, Kurtosis, CV. Muốn có cả biểu đồ và kiểm định chuẩn trong một trang: Stat → Basic Statistics → Graphical Summary – ra histogram, box plot, khoảng tin cậy cho trung bình/trung vị và p-value Anderson-Darling.
Khi nào dùng chỉ số nào?
- Dữ liệu đối xứng, không ngoại lai → trung bình + độ lệch chuẩn.
- Dữ liệu lệch (thời gian chờ, thời gian sửa chữa, độ nhám) → báo cáo thêm trung vị + IQR, xem box plot.
- Dữ liệu thuộc tính (loại lỗi, ca) → mode, tần suất, tỷ lệ, xem dữ liệu thuộc tính vs dữ liệu biến.
- So sánh độ ổn định hai đặc tính khác đơn vị → CV.
Lỗi thường gặp
- Chỉ báo cáo trung bình. Hai máy cùng trung bình 2,50 mm nhưng s = 0,01 và s = 0,05 là hai câu chuyện hoàn toàn khác.
- Nhầm STDEV.P với STDEV.S. Dữ liệu là mẫu thì dùng STDEV.S.
- Gộp dữ liệu nhiều máy/khuôn/ca rồi tính một độ lệch chuẩn – che mất nguồn biến động. Hãy phân tầng trước.
- Không nhìn biểu đồ. Luôn kèm histogram hoặc box plot; hai bộ dữ liệu có cùng x̄ và s vẫn có thể khác hình dạng hoàn toàn.
- Làm tròn quá sớm trong khi tính tay, sai số tích luỹ đáng kể khi bình phương.
- Tin độ lệch/độ nhọn với n nhỏ (< 30) – chúng dao động rất mạnh.
Câu hỏi thường gặp
Độ lệch chuẩn bao nhiêu là “tốt”? Không có con số chung. Phải so với dung sai: tỷ lệ (USL − LSL) / 6s chính là ý tưởng của chỉ số năng lực Cp, xem nghiên cứu năng lực quá trình.
Có cần bao nhiêu dữ liệu để tính thống kê mô tả? Tính được với bất kỳ n nào, nhưng để ước lượng s đáng tin nên có từ 25–30 giá trị trở lên; với độ lệch/độ nhọn cần nhiều hơn nữa (xem xác định cỡ mẫu).
Range hay độ lệch chuẩn tốt hơn? Với nhóm con nhỏ (n ≤ 8), range đơn giản và đủ hiệu quả, đó là lý do biểu đồ Xbar-R dùng range. Với n lớn, độ lệch chuẩn tận dụng toàn bộ dữ liệu nên chính xác hơn.
Bước tiếp theo
- Tìm hiểu hình dạng “chuẩn” mà nhiều công cụ giả định: Phân phối chuẩn và kiểm định chuẩn.
- Vì sao trung bình mẫu lại đáng tin: Định lý giới hạn trung tâm.
- Từ mô tả sang suy luận: Khoảng tin cậy và Kiểm định giả thuyết.