Industrial Knowledge
Khoảng tin cậy là gì? Cách tính cho trung bình, tỷ lệ và đọc đúng | Ví dụ
Nội dung bài viết 11 mục
- Khoảng tin cậy là gì?
- Công thức
- Ví dụ 1: khoảng tin cậy cho trung bình lực kéo đứt (minh hoạ)
- Ví dụ 2: khoảng tin cậy cho tỷ lệ lỗi (minh hoạ)
- Ví dụ 3: khoảng tin cậy cho độ lệch chuẩn (minh hoạ)
- Ước lượng điểm hay ước lượng khoảng?
- Đọc đúng và đọc sai
- Làm trong Excel và Minitab
- Lỗi thường gặp
- Câu hỏi thường gặp
- Bước tiếp theo
“Lực kéo đứt trung bình là 152 N” – con số này chính xác đến đâu? Nếu đo 25 mẫu khác, có thể ra 150 hay 155. Báo cáo một con số duy nhất che đi sự không chắc chắn đó. Khoảng tin cậy cho biết giá trị thật của tổng thể có thể nằm trong vùng nào, và là cách trình bày kết quả trung thực hơn hẳn một điểm ước lượng.
Tóm tắt nhanh
- Khoảng tin cậy (CI) là khoảng giá trị tính từ dữ liệu mẫu, cho biết ước lượng chính xác đến đâu.
- CI = ước lượng điểm ± sai số biên; sai số biên = giá trị tới hạn × sai số chuẩn.
- Độ rộng phụ thuộc độ tin cậy (90/95/99%), độ biến động và cỡ mẫu n; muốn hẹp thì tăng n.
- Ví dụ: 18 lỗi/400 sản phẩm → p̂ = 4,5%, CI 95% khoảng 2,5% đến 6,5%.
- CI tỷ lệ kiểu Wald cần n·p̂ ≥ 10 và n·(1 − p̂) ≥ 10.
Khoảng tin cậy là gì?
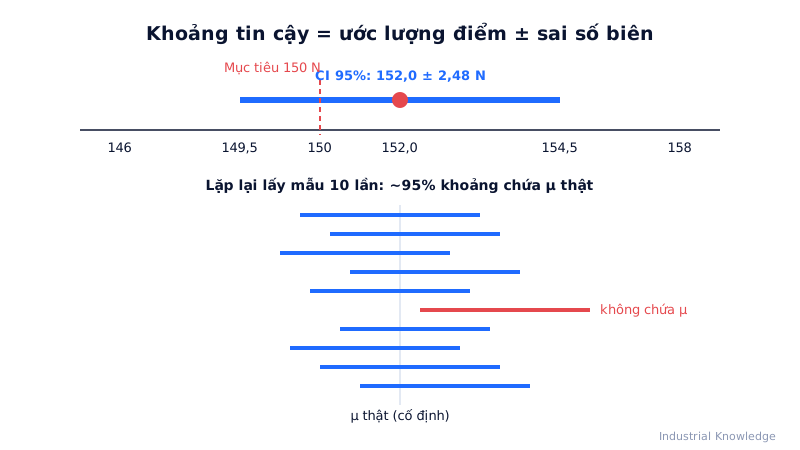
Khoảng tin cậy (confidence interval – CI) là một khoảng giá trị, tính từ dữ liệu mẫu, được xây dựng theo một phương pháp mà nếu lặp lại việc lấy mẫu rất nhiều lần thì khoảng 95% (với độ tin cậy 95%) số khoảng tạo ra sẽ chứa tham số thật của tổng thể.
Cấu trúc chung:
CI = Ước lượng điểm ± Sai số biên (margin of error) Sai số biên = Giá trị tới hạn × Sai số chuẩn
Ba yếu tố quyết định độ rộng: độ tin cậy (90%, 95%, 99%), độ biến động (σ hoặc s) và cỡ mẫu n. Khoảng hẹp = ước lượng chính xác.
Công thức
| Trường hợp | Công thức | Điều kiện |
|---|---|---|
| Trung bình, biết σ | x̄ ± Z(α/2) × σ / √n | Hiếm gặp thực tế |
| Trung bình, chưa biết σ (thông dụng) | x̄ ± t(α/2; n−1) × s / √n | Dữ liệu gần chuẩn hoặc n đủ lớn |
| Tỷ lệ (Wald) | p̂ ± Z(α/2) × √[p̂(1 − p̂) / n] | n·p̂ ≥ 10 và n·(1 − p̂) ≥ 10 |
| Độ lệch chuẩn | Dựa trên phân phối Chi bình phương | Rất nhạy với giả định chuẩn |
Giá trị tới hạn Z hay dùng:
| Độ tin cậy | α | Z(α/2) |
|---|---|---|
| 90% | 0,10 | 1,645 |
| 95% | 0,05 | 1,960 |
| 99% | 0,01 | 2,576 |
Giá trị t lớn hơn Z khi n nhỏ (vì s cũng là ước lượng), và tiến dần về Z khi n tăng.
Ví dụ 1: khoảng tin cậy cho trung bình lực kéo đứt (minh hoạ)
Một nhà máy dây cáp ở Hải Phòng thử kéo đứt n = 25 mẫu: x̄ = 152,0 N, s = 6,0 N. Yêu cầu khách hàng: trung bình ≥ 150 N.
Bước 1 – Sai số chuẩn: SE = 6,0 / √25 = 6,0 / 5 = 1,2 N.
Bước 2 – Giá trị tới hạn: bậc tự do 24, độ tin cậy 95% → t = 2,064.
Bước 3 – Sai số biên: 2,064 × 1,2 ≈ 2,48 N.
Bước 4 – Khoảng tin cậy 95%: 152,0 ± 2,48 → (149,5 ; 154,5) N.
Bước 5 – Diễn giải: khoảng chứa cả giá trị 150 N, nên với dữ liệu hiện tại chưa thể khẳng định trung bình tổng thể đạt ≥ 150 N, dù x̄ = 152. Muốn kết luận chắc hơn: giảm biến động hoặc tăng cỡ mẫu. Đây cũng chính là logic của t-test một mẫu.
Ví dụ 2: khoảng tin cậy cho tỷ lệ lỗi (minh hoạ)
Kiểm 400 sản phẩm nhựa ép, phát hiện 18 sản phẩm lỗi bavia.
Bước 1 – Tỷ lệ mẫu: p̂ = 18 / 400 = 0,045 (4,5%). Kiểm tra điều kiện: n·p̂ = 18 ≥ 10 ✓, n·(1 − p̂) = 382 ✓.
Bước 2 – Sai số chuẩn: √(0,045 × 0,955 / 400) = √0,000107 ≈ 0,0104.
Bước 3 – Sai số biên 95%: 1,96 × 0,0104 ≈ 0,020.
Bước 4 – Khoảng tin cậy: 0,045 ± 0,020 → khoảng 2,5% đến 6,5%.
Diễn giải: nếu mục tiêu là tỷ lệ lỗi ≤ 3%, dữ liệu này chưa đủ để nói đạt hay không – khoảng quá rộng. Đây là đặc điểm của dữ liệu thuộc tính: cần cỡ mẫu lớn hơn nhiều so với dữ liệu biến. Với tỷ lệ lỗi rất thấp hoặc số lỗi ít, nên dùng phương pháp chính xác (exact) thay cho công thức Wald.
So sánh với phương pháp chính xác (Clopper-Pearson – mặc định của Minitab 1 Proportion): cùng 18/400 cho khoảng 2,7% đến 7,0%. Khoảng exact không đối xứng quanh 4,5% và rộng hơn một chút về phía trên – điều này càng rõ khi số lỗi ít.
Ví dụ 3: khoảng tin cậy cho độ lệch chuẩn (minh hoạ)
Quay lại dữ liệu lực kéo đứt (n = 25, s = 6,0 N). Khoảng tin cậy cho σ dùng phân phối Chi bình phương với n − 1 = 24 bậc tự do:
σ ∈ ( √[(n − 1)s² / χ²(0,025)] ; √[(n − 1)s² / χ²(0,975)] ), trong đó χ²(0,025) = 39,36 là giá trị cắt 2,5% đuôi phải và χ²(0,975) = 12,40 là giá trị cắt 2,5% đuôi trái.
→ √(864 / 39,36) ≈ 4,7 N đến √(864 / 12,40) ≈ 8,3 N.
Khoảng rất rộng (gần gấp đôi từ đầu này sang đầu kia) dù đã có 25 mẫu – đó là lý do Cpk tính từ 25–30 điểm vẫn có sai số lớn. Lưu ý khoảng cho σ không dùng được CLT: nếu dữ liệu không chuẩn, kết quả có thể lệch đáng kể.
Ước lượng điểm hay ước lượng khoảng?
- Ước lượng điểm: một con số duy nhất (x̄ = 152 N, p̂ = 4,5%). Dễ báo cáo nhưng không cho biết độ tin cậy.
- Ước lượng khoảng: thêm sai số biên, nói rõ “chắc chắn đến đâu”. Với quyết định quan trọng (chấp nhận nguyên liệu, công bố cải tiến), luôn báo cáo khoảng.
- Khoảng tin cậy chỉ phản ánh sai số do lấy mẫu ngẫu nhiên. Nó không bù được mẫu thiên lệch (chỉ lấy lô đẹp, chỉ lấy ca ngày) hay hệ đo sai – những lỗi đó phải xử lý bằng cách lấy mẫu đúng và phân tích hệ thống đo.
Đọc đúng và đọc sai
| Cách nói | Đúng/Sai | Giải thích |
|---|---|---|
| “Có 95% xác suất μ nằm trong (149,5; 154,5)” | Sai (theo nghĩa chặt) | μ là hằng số; khoảng đã tính hoặc chứa hoặc không chứa μ. 95% là độ tin cậy của phương pháp |
| “Chúng tôi tin cậy 95% rằng μ nằm trong khoảng này” | Đúng (cách nói thực hành) | Hàm ý phương pháp đúng 95% số lần |
| “95% sản phẩm có lực kéo trong (149,5; 154,5)” | Sai | CI nói về trung bình, không phải sản phẩm đơn lẻ. Muốn nói về sản phẩm cần khoảng dung sai thống kê (tolerance interval) |
| “Khoảng hai nhóm chồng nhau nên không khác biệt” | Không chắc chắn | Chồng nhau một phần vẫn có thể khác biệt có ý nghĩa; hãy dùng CI cho hiệu số hoặc kiểm định |
| “CI 99% tốt hơn CI 95%” | Không hẳn | Tin cậy cao hơn nhưng khoảng rộng hơn, kém chính xác |
Liên hệ với kiểm định: CI 95% không chứa giá trị mục tiêu ⇔ kiểm định hai phía với α = 0,05 bác bỏ H0. Xem kiểm định giả thuyết cơ bản.
Làm trong Excel và Minitab
Excel:
| Mục đích | Hàm |
|---|---|
| Sai số biên trung bình (t) | =CONFIDENCE.T(0,05; s; n) → =CONFIDENCE.T(0,05;6;25) ≈ 2,48 |
| Sai số biên trung bình (Z) | =CONFIDENCE.NORM(0,05; σ; n) |
| Giá trị t tới hạn | =T.INV.2T(0,05; 24) ≈ 2,064 |
| Giá trị Z tới hạn | =NORM.S.INV(0,975) ≈ 1,96 |
| Sai số biên tỷ lệ | =1,96*SQRT(p*(1-p)/n) |
Analysis ToolPak → Descriptive Statistics, tick Confidence Level for Mean cũng cho sai số biên.
Minitab:
- Trung bình: Stat → Basic Statistics → 1-Sample t (bỏ trống Hypothesized mean để chỉ lấy CI; Options chọn độ tin cậy).
- Tỷ lệ: Stat → Basic Statistics → 1 Proportion (mặc định phương pháp exact; có thể chọn normal approximation).
- Độ lệch chuẩn: Stat → Basic Statistics → 1 Variance.
- Nhanh gọn: Graphical Summary hiển thị sẵn CI 95% cho trung bình, trung vị và độ lệch chuẩn.
Lỗi thường gặp
- Dùng Z thay cho t với cỡ mẫu nhỏ → khoảng hẹp giả tạo.
- Hiểu CI là khoảng chứa 95% sản phẩm.
- Dữ liệu không độc lập (đo lặp trên cùng một chi tiết) nhưng vẫn chia cho √n.
- Dùng công thức Wald khi số lỗi rất ít (vài lỗi) → khoảng sai, có thể ra số âm.
- Báo cáo x̄ mà không kèm CI, rồi ra quyết định đầu tư dựa trên khác biệt nằm trong nhiễu.
Câu hỏi thường gặp
Muốn khoảng hẹp lại một nửa thì làm sao? Tăng cỡ mẫu lên khoảng 4 lần (vì sai số biên tỷ lệ với 1/√n), hoặc giảm biến động quá trình/hệ đo. Xem xác định cỡ mẫu.
Nên chọn 90%, 95% hay 99%? 95% là mặc định phổ biến. Dùng 99% khi hậu quả sai lầm nghiêm trọng (an toàn), 90% cho nghiên cứu sơ bộ.
Dữ liệu không chuẩn thì sao? Với n vừa đủ, CI cho trung bình vẫn ổn nhờ định lý giới hạn trung tâm. Dữ liệu lệch mạnh nên dùng CI cho trung vị hoặc bootstrap.
Bước tiếp theo
- So sánh hai nhóm: t-test, nhiều nhóm: ANOVA một yếu tố.
- Kiểm tra giả định: Phân phối chuẩn và kiểm định chuẩn.
- Lập kế hoạch lấy mẫu: Xác định cỡ mẫu.