Industrial Knowledge
Cách xác định cỡ mẫu: ước lượng trung bình, tỷ lệ, so sánh 2 nhóm | Ví dụ
Nội dung bài viết 11 mục
- Cỡ mẫu phụ thuộc vào gì?
- Công thức
- Ví dụ 1: ước lượng trung bình khối lượng gói (minh hoạ)
- Ví dụ 2: ước lượng tỷ lệ lỗi (minh hoạ)
- Ví dụ 3: so sánh hai nhà cung cấp hạt nhựa (minh hoạ)
- Lô nhỏ: hiệu chỉnh tổng thể hữu hạn
- Cỡ mẫu đúng nhưng cách lấy sai thì vẫn hỏng
- Làm trong Excel và Minitab
- Lỗi thường gặp
- Câu hỏi thường gặp
- Bước tiếp theo
“Lấy bao nhiêu mẫu là đủ?” – câu hỏi gặp ở mọi dự án cải tiến, mọi lần thử nghiệm nguyên liệu mới. Lấy quá ít thì kết luận như đoán mò, bỏ sót cải tiến thật; lấy quá nhiều thì tốn thời gian, vật tư và máy dừng. Xác định cỡ mẫu là bước thiết kế trước khi thu dữ liệu, không phải con số chọn cho đẹp như “30” hay “50”.
Tóm tắt nhanh
- Xác định cỡ mẫu là bước thiết kế trước khi thu dữ liệu, không phải chọn số đẹp như 30 hay 50.
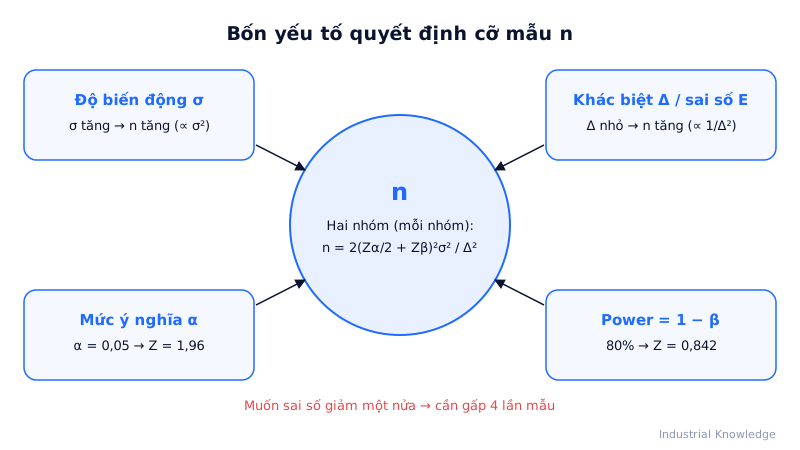
- n tăng theo σ², tỷ lệ với 1/E², và tăng khi α nhỏ hơn hoặc power cao hơn.
- Quy ước thường dùng: α = 0,05, power = 0,80 (Z = 1,960 hai phía và 0,842).
- Ước lượng trung bình: n = (Z(α/2) × σ / E)².
Cỡ mẫu phụ thuộc vào gì?
| Yếu tố | Ký hiệu | Ảnh hưởng tới n |
|---|---|---|
| Độ biến động | σ | σ lớn → cần nhiều mẫu hơn (tỷ lệ với σ²) |
| Sai số chấp nhận / khác biệt cần phát hiện | E hoặc Δ | Muốn chính xác hơn, phát hiện khác biệt nhỏ hơn → n tăng mạnh (tỷ lệ với 1/E²) |
| Mức ý nghĩa | α | α nhỏ hơn (tin cậy cao hơn) → n tăng |
| Độ mạnh kiểm định | Power = 1 − β | Power cao hơn → n tăng |
Nhắc lại hai loại sai lầm (chi tiết ở kiểm định giả thuyết):
| Thực tế không khác biệt | Thực tế có khác biệt | |
|---|---|---|
| Kết luận “có khác biệt” | Sai lầm loại I (α) – báo động nhầm | Đúng (power) |
| Kết luận “không khác biệt” | Đúng | Sai lầm loại II (β) – bỏ sót |
Quy ước thường dùng: α = 0,05; power = 0,80 (β = 0,20). Giá trị Z tương ứng:
| Tham số | Giá trị | Z |
|---|---|---|
| α = 0,05 hai phía | Z(α/2) | 1,960 |
| α = 0,05 một phía | Z(α) | 1,645 |
| Power 80% | Z(β) | 0,842 |
| Power 90% | Z(β) | 1,282 |
Công thức
1. Ước lượng trung bình với sai số biên E: n = (Z(α/2) × σ / E)²
2. Ước lượng tỷ lệ với sai số biên E: n = Z(α/2)² × p × (1 − p) / E² Chưa biết p → dùng p = 0,5 (cho n lớn nhất, an toàn).
3. So sánh trung bình hai nhóm (cỡ mẫu mỗi nhóm), phát hiện khác biệt Δ: n = 2 × (Z(α/2) + Z(β))² × σ² / Δ²
Luôn làm tròn lên. Các công thức dùng Z là gần đúng; phần mềm dùng phân phối t nên thường cho n lớn hơn 1–2 đơn vị.
σ lấy từ đâu? Dữ liệu lịch sử, biểu đồ kiểm soát, nghiên cứu năng lực, hoặc một thử nghiệm sơ bộ nhỏ. Nếu không chắc, chọn σ hơi lớn để an toàn.
Ví dụ 1: ước lượng trung bình khối lượng gói (minh hoạ)
Nhà máy thực phẩm ở Long An muốn ước lượng khối lượng trung bình gói bột nêm với sai số ±0,25 g, độ tin cậy 95%. Dữ liệu cũ cho σ ≈ 0,8 g.
n = (1,96 × 0,8 / 0,25)² = (6,272)² ≈ 39,3 → 40 gói.
Nếu muốn sai số ±0,125 g (giảm một nửa) → n ≈ 157, gấp khoảng 4 lần. Đây là quy luật √n đã gặp ở định lý giới hạn trung tâm.
Ví dụ 2: ước lượng tỷ lệ lỗi (minh hoạ)
Phòng QC muốn ước lượng tỷ lệ lỗi in nhãn, dự đoán khoảng 5%, sai số ±2%, tin cậy 95%.
n = 1,96² × 0,05 × 0,95 / 0,02² = 3,8416 × 0,0475 / 0,0004 ≈ 456,2 → 457 sản phẩm.
So với ví dụ 1, dữ liệu thuộc tính cần mẫu lớn hơn rất nhiều – một lý do nên đo dữ liệu biến thay vì dữ liệu thuộc tính khi có thể. Nếu không biết trước p, dùng p = 0,5 → n ≈ 2.401.
Ví dụ 3: so sánh hai nhà cung cấp hạt nhựa (minh hoạ)
Kỹ sư muốn biết hạt nhựa nhà cung cấp mới có làm thay đổi độ bền va đập ít nhất 1,0 kJ/m² hay không. σ ước lượng = 1,5 kJ/m², α = 0,05 (hai phía), power = 80%.
Bước 1: (Z(α/2) + Z(β))² = (1,96 + 0,842)² ≈ 7,85. Bước 2: σ² / Δ² = 2,25 / 1,0 = 2,25. Bước 3: n = 2 × 7,85 × 2,25 ≈ 35,3 → 36 mẫu mỗi nhà cung cấp.
Minitab (dùng phân phối t) cho khoảng 37 mẫu/nhóm. Với chỉ 10 mẫu mỗi nhóm, power để phát hiện khác biệt 1,0 chỉ khoảng 30% – tức gần 70% khả năng bỏ sót khác biệt thật. Phân tích bằng t-test hai mẫu sau khi thu dữ liệu.
Lô nhỏ: hiệu chỉnh tổng thể hữu hạn
Các công thức trên giả định tổng thể rất lớn. Khi lô chỉ có N đơn vị và n tính ra chiếm hơn ~5% lô, hiệu chỉnh:
n’ = n / [1 + (n − 1) / N]
Ví dụ 2 với lô nhãn chỉ N = 2.000 cái: n’ = 457 / (1 + 456 / 2.000) ≈ 372,1 → 373 sản phẩm thay vì 457. Với lô 100.000 cái, hiệu chỉnh gần như không đáng kể.
Cỡ mẫu đúng nhưng cách lấy sai thì vẫn hỏng
Con số n chỉ có ý nghĩa khi mẫu đại diện cho tổng thể. Các cách lấy mẫu thường gặp:
| Phương pháp | Cách làm | Khi dùng ở nhà máy |
|---|---|---|
| Ngẫu nhiên đơn giản | Mỗi đơn vị có cùng cơ hội được chọn (bốc số ngẫu nhiên, RAND()) | Lô đồng nhất, có danh sách/đánh số |
| Phân tầng | Chia theo tầng (máy, khuôn, ca, nhà cung cấp), lấy ngẫu nhiên trong từng tầng | Khi biết các tầng khác nhau – vừa chính xác hơn vừa so sánh được giữa tầng |
| Hệ thống | Lấy 1 đơn vị mỗi k = N/n đơn vị, điểm bắt đầu ngẫu nhiên | Dây chuyền chạy liên tục; cẩn thận nếu quá trình có chu kỳ trùng với k (ví dụ khuôn 4 cavity, lấy mỗi 4 cái) |
| Cụm | Chọn ngẫu nhiên vài thùng/pallet, lấy toàn bộ trong đó | Nhanh, rẻ khi kiểm hàng trong kho; cần n lớn hơn vì các đơn vị cùng thùng giống nhau |
| Thuận tiện / phán đoán | Lấy chỗ dễ lấy, hoặc theo kinh nghiệm người kiểm | Chỉ cho khảo sát sơ bộ – không dùng để kết luận thống kê |
Một lỗi kinh điển: cùng 40 mẫu nhưng lấy hết ở đầu ca sẽ không nói được gì về cuối ca khi dao đã mòn.
Làm trong Excel và Minitab
Excel:
| Mục đích | Công thức |
|---|---|
| Z(α/2) | =NORM.S.INV(1-0,05/2) |
| Z(β) cho power 80% | =NORM.S.INV(0,8) |
| Cỡ mẫu trung bình | =ROUNDUP((NORM.S.INV(0,975)*0,8/0,25)^2;0) → 40 |
| Cỡ mẫu tỷ lệ | =ROUNDUP(NORM.S.INV(0,975)^2*0,05*0,95/0,02^2;0) → 457 |
| Hai nhóm | =ROUNDUP(2*(NORM.S.INV(0,975)+NORM.S.INV(0,8))^2*1,5^2/1^2;0) → 36 |
Minitab: Stat → Power and Sample Size, chọn loại phân tích:
- Sample Size for Estimation → Mean (Normal) hoặc Proportion (Binomial): nhập σ, sai số biên.
- 1-Sample t, 2-Sample t, 1 Proportion, 2 Proportions, One-Way ANOVA: nhập hai trong ba đại lượng (sample size, differences, power), Minitab tính đại lượng còn lại; xem thêm biểu đồ power curve.
Ngược lại, khi đã có sẵn n (dữ liệu hạn chế), dùng cùng menu để tính power – biết trước mình có khả năng phát hiện khác biệt đến đâu.
Lỗi thường gặp
- Chọn “30 mẫu” theo thói quen mà không xét σ, Δ.
- Không xác định Δ có ý nghĩa thực tế trước – Δ phải xuất phát từ dung sai, chi phí, yêu cầu khách hàng chứ không phải từ thống kê.
- Kết luận “không khác biệt” từ mẫu nhỏ – thực ra là power thấp, chưa đủ bằng chứng.
- Đếm mẫu không độc lập: đo 5 lần trên cùng 1 chi tiết không phải 5 mẫu.
- Quên tính hao hụt (mẫu hỏng, mất nhãn) – nên cộng thêm 5–10%.
- Dùng σ quá lạc quan từ một lô tốt.
Câu hỏi thường gặp
Cỡ mẫu có phụ thuộc vào kích thước lô không? Với lô lớn thì gần như không. Chỉ khi mẫu chiếm phần đáng kể (> 5%) của lô nhỏ mới dùng hiệu chỉnh tổng thể hữu hạn, làm giảm n. Lưu ý đây là cỡ mẫu cho ước lượng/nghiên cứu, khác với phương án lấy mẫu nghiệm thu AQL.
Power 80% có đủ không? Đủ cho đa số nghiên cứu cải tiến. Với quyết định quan trọng (đổi vật liệu cho chi tiết an toàn), nên chọn 90%.
Chưa có dữ liệu σ thì làm sao? Làm thử nghiệm sơ bộ 10–15 mẫu để ước lượng σ, hoặc ước lượng thô σ ≈ khoảng biến động thường gặp / 6.
Bước tiếp theo
- Hiểu bản chất sai số chuẩn: Định lý giới hạn trung tâm.
- Trình bày kết quả: Khoảng tin cậy.
- Phân tích sau thu thập: t-test, ANOVA một yếu tố, Kiểm định Chi bình phương.