Industrial Knowledge
Kiểm định Chi-bình phương là gì? Độc lập và phù hợp | Ví dụ tỷ lệ lỗi theo ca
Nội dung bài viết 8 mục
Không phải dữ liệu nào cũng đo bằng thước. Rất nhiều dữ liệu nhà máy là đếm: OK/NG, loại lỗi, ca làm việc, nhà cung cấp, ngày trong tuần. Với dữ liệu dạng này, t-test và ANOVA không dùng được. Công cụ đúng là kiểm định Chi-bình phương (χ²).
Tóm tắt nhanh
- Kiểm định Chi-bình phương so sánh tần số quan sát O với tần số kỳ vọng E: χ² = Σ (O − E)² / E.
- Hai dạng chính: kiểm định độc lập (bảng chéo, ví dụ ca × OK/NG) và kiểm định phù hợp (phân bố đếm có khớp tỷ lệ giả định).
- Dữ liệu phải là số đếm, không phải phần trăm hay trung bình.
- Ví dụ: 150 phiếu lỗi theo ngày cho χ² = 11,20 > 11,07 (p = 0,048), thứ Hai đóng góp 60%.
Kiểm định Chi-bình phương là gì?
Kiểm định Chi-bình phương so sánh tần số quan sát (O) với tần số kỳ vọng (E) - số lượng ta “đáng lẽ” thấy nếu H0 đúng. Chênh lệch càng lớn, χ² càng lớn.
χ² = Σ (O − E)² / E
Có hai dạng chính:
| Dạng | Câu hỏi | E tính thế nào | Bậc tự do |
|---|---|---|---|
| Kiểm định độc lập (bảng chéo r × c) | Hai biến phân loại có liên quan? (ca × OK/NG) | E = (tổng hàng × tổng cột) / tổng chung | (r − 1)(c − 1) |
| Kiểm định phù hợp (goodness of fit) | Phân bố đếm có khớp tỷ lệ giả định? (lỗi đều các ngày?) | E = n × tỷ lệ giả định | k − 1 |
H0 của kiểm định độc lập: “tỷ lệ NG không phụ thuộc ca”. H0 của kiểm định phù hợp: “dữ liệu tuân theo phân bố giả định”.
Giả định và điều kiện
- Dữ liệu là số đếm (tần số), không phải phần trăm hay trung bình. Luôn đưa số lượng thực vào bảng.
- Quan sát độc lập - mỗi sản phẩm chỉ rơi vào một ô.
- Tần số kỳ vọng đủ lớn: quy tắc phổ biến là E ≥ 5 ở ít nhất 80% số ô và không ô nào E < 1. Không đạt: gộp nhóm, tăng mẫu, hoặc dùng Fisher exact test (bảng 2×2 nhỏ).
- Dữ liệu cặp (cùng sản phẩm đánh giá hai lần, ví dụ hai kiểm viên): dùng McNemar, không dùng χ² độc lập.
Ví dụ 1 - Kiểm định độc lập: tỷ lệ NG theo ca
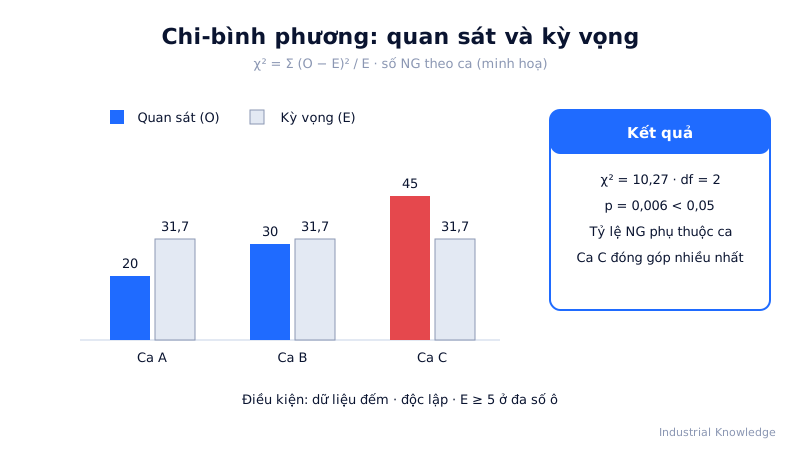
Một nhà máy ép nhựa ở Đồng Nai ghi nhận trong một tuần (minh hoạ):
| Ca | OK | NG | Tổng | % NG |
|---|---|---|---|---|
| A (6h-14h) | 1.180 | 20 | 1.200 | 1,67% |
| B (14h-22h) | 1.170 | 30 | 1.200 | 2,50% |
| C (22h-6h) | 1.155 | 45 | 1.200 | 3,75% |
| Tổng | 3.505 | 95 | 3.600 | 2,64% |
Bước 1 - Giả thuyết: H0: tỷ lệ NG như nhau ở 3 ca; H1: có ca khác; α = 0,05.
Bước 2 - Tần số kỳ vọng: nếu H0 đúng, mỗi ca có tỷ lệ NG chung 95/3.600.
- E(NG) mỗi ca = 1.200 × 95 / 3.600 = 31,67
- E(OK) mỗi ca = 1.200 × 3.505 / 3.600 = 1.168,33
Tất cả E ≫ 5 → điều kiện đạt.
Bước 3 - Đóng góp từng ô (O − E)²/E:
| Ca | OK | NG |
|---|---|---|
| A | (1180 − 1168,33)²/1168,33 = 0,117 | (20 − 31,67)²/31,67 = 4,298 |
| B | 0,002 | 0,088 |
| C | 0,152 | 5,614 |
Bước 4 - Tổng: χ² = 0,117 + 4,298 + 0,002 + 0,088 + 0,152 + 5,614 = 10,27; df = (3 − 1)(2 − 1) = 2.
Bước 5 - Kết luận: χ² tới hạn (0,05; 2) = 5,99; p = 0,0059 < 0,05 → bác bỏ H0. Tỷ lệ NG phụ thuộc ca. Bảng đóng góp cho biết “thủ phạm”: ca C cao bất thường và ca A thấp bất thường. Hướng điều tra: ánh sáng khu kiểm, nhiệt độ khuôn ban đêm, kinh nghiệm công nhân ca đêm - dùng sơ đồ xương cá 6M để liệt kê.
Ví dụ 2 - Kiểm định phù hợp: lỗi có rải đều các ngày?
150 phiếu lỗi trong tháng chia theo ngày: T2 38, T3 22, T4 20, T5 19, T6 21, T7 30. H0: lỗi phân bố đều → E = 150/6 = 25 mỗi ngày.
χ² = (38−25)²/25 + (22−25)²/25 + (20−25)²/25 + (19−25)²/25 + (21−25)²/25 + (30−25)²/25 = 6,76 + 0,36 + 1,00 + 1,44 + 0,64 + 1,00 = 11,20; df = 5.
χ² tới hạn (0,05; 5) = 11,07; p = 0,048 → bác bỏ H0, dù sát ngưỡng. Thứ Hai đóng góp 6,76/11,2 = 60% - gợi ý vấn đề khởi động máy sau ngày nghỉ. Vì p sát 0,05, nên thu thêm 1-2 tháng dữ liệu trước khi đầu tư lớn.
Làm trong Excel và Minitab
Excel:
- Lập bảng quan sát và bảng kỳ vọng (E = tổng hàng × tổng cột / tổng chung, dùng tham chiếu
$). =CHISQ.TEST(vùng_quan_sát; vùng_kỳ_vọng)→ trả về p-value trực tiếp.- Thống kê χ²:
=SUMPRODUCT((O-E)^2/E)hoặc=CHISQ.INV.RT(p; df). Giá trị tới hạn:=CHISQ.INV.RT(0,05; 2). - Lưu ý:
CHISQ.TESTdùng df = (r−1)(c−1); với kiểm định phù hợp vẫn dùng được khi đưa một cột O và một cột E (df = k − 1).
Minitab:
- Bảng đã tổng hợp: Stat → Tables → Chi-Square Test for Association → Summarized data in a two-way table. Tick Each cell’s contribution to chi-square trong Statistics.
- Dữ liệu thô (mỗi dòng một sản phẩm): cùng menu, chọn Raw data (categorical variables).
- Phù hợp: Stat → Tables → Chi-Square Goodness-of-Fit Test (One Variable) → Equal proportions hoặc nhập tỷ lệ riêng.
- Chỉ 2 tỷ lệ: Stat → Basic Statistics → 2 Proportions (thay thế cho bảng 2×2).
Lỗi thường gặp
- Đưa phần trăm vào bảng thay vì số đếm → χ² sai hoàn toàn (phụ thuộc cỡ mẫu).
- Ô kỳ vọng quá nhỏ (vd. 3 loại lỗi hiếm, E = 1,2) → p không tin cậy. Gộp các loại hiếm thành “khác”.
- Kết luận nhân quả: χ² chỉ nói có liên quan; ca C nhiều lỗi có thể do được giao sản phẩm khó hơn.
- Không xem bảng đóng góp → biết “có khác” nhưng không biết khác ở đâu.
- Một sản phẩm đếm nhiều lần (có 2 lỗi → vào 2 ô) → vi phạm độc lập.
Câu hỏi thường gặp
χ² với bảng 2×2 có cần hiệu chỉnh Yates? Với n lớn, ảnh hưởng không đáng kể. Với n nhỏ, nhiều phần mềm áp hiệu chỉnh hoặc nên dùng Fisher exact.
Khác gì so với kiểm định 2 tỷ lệ? Với 2 nhóm × 2 kết quả, χ² (không hiệu chỉnh) tương đương kiểm định 2 tỷ lệ hai phía. χ² mở rộng được cho 3+ nhóm và 3+ loại kết quả.
Dùng χ² để kiểm tra dữ liệu có chuẩn không? Về lý thuyết được (chia nhóm), nhưng Anderson-Darling mạnh hơn - xem kiểm định chuẩn.
Bước tiếp theo
- Ôn khung chung: kiểm định giả thuyết.
- Dữ liệu liên tục theo nhóm: ANOVA một yếu tố.
- Phân loại lỗi trước khi kiểm định: thống kê mô tả.