Industrial Knowledge
Phân phối chuẩn là gì? Quy tắc 68-95-99,7, Z-score và kiểm định chuẩn | Ví dụ
Nội dung bài viết 9 mục
Phân phối chuẩn là “ngôn ngữ chung” của Six Sigma: giới hạn kiểm soát ±3σ, chỉ số Cpk, t-test, ANOVA… đều dựa trên nó ở mức độ nào đó. Hiểu phân phối chuẩn giúp bạn ước lượng tỷ lệ phế phẩm từ vài chục số đo, và quan trọng không kém – biết khi nào dữ liệu KHÔNG chuẩn để không áp công thức sai.
Tóm tắt nhanh
- Phân phối chuẩn có hình chuông đối xứng quanh μ; là nền của giới hạn ±3σ, Cpk, t-test, ANOVA.
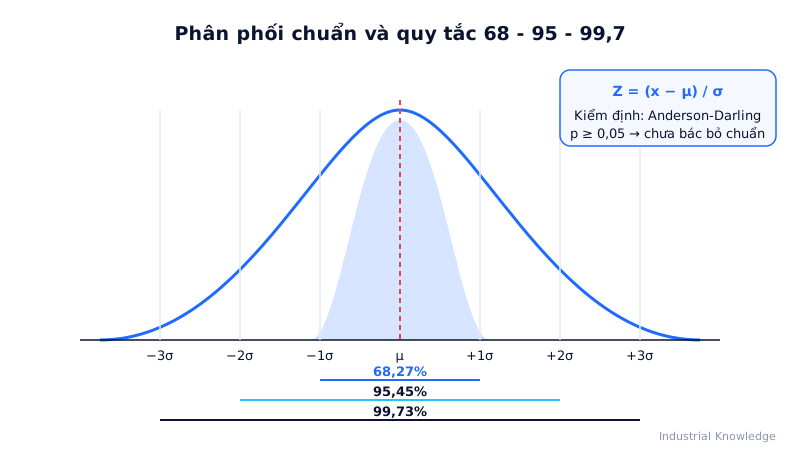
- Quy tắc 68-95-99,7: μ ± 1σ chứa ≈ 68,27%, ± 2σ ≈ 95,45%, ± 3σ ≈ 99,73% dữ liệu.
- Phải kiểm định chuẩn trước khi tính Cpk, ppm; dữ liệu không chuẩn cần tìm nguyên nhân trước khi biến đổi.
- Lỗi lớn: coi p > 0,05 là bằng chứng chắc chắn chuẩn, Box-Cox để “cho đạt” khi thực chất trộn hai quá trình.
Phân phối chuẩn là gì?
Phân phối chuẩn (normal / Gaussian distribution) là phân phối liên tục có hình chuông, đối xứng quanh trung bình μ, được xác định hoàn toàn bởi hai tham số: μ (vị trí) và σ (độ rộng). Đặc điểm:
- Trung bình = trung vị = mode, nằm ở đỉnh chuông.
- Đối xứng: 50% dữ liệu mỗi bên của μ.
- Hai đuôi kéo dài vô hạn nhưng giảm rất nhanh.
- Tổng diện tích dưới đường cong = 1 (100%).
Vì sao nhiều đặc tính trong nhà máy gần chuẩn? Vì kích thước, khối lượng, độ dày… thường là kết quả cộng dồn của rất nhiều nguồn biến động nhỏ, độc lập (nhiệt độ, độ mòn dao, vật liệu, thao tác). Tổng của nhiều yếu tố nhỏ có xu hướng ra hình chuông – ý tưởng gắn với định lý giới hạn trung tâm.
Quy tắc 68-95-99,7 và Z-score
| Khoảng | Tỷ lệ nằm trong | Tỷ lệ nằm ngoài |
|---|---|---|
| μ ± 1σ | ≈ 68,27% | ≈ 31,7% |
| μ ± 2σ | ≈ 95,45% | ≈ 4,55% |
| μ ± 3σ | ≈ 99,73% | ≈ 0,27% (2.700 ppm) |
Z-score chuyển mọi phân phối chuẩn về phân phối chuẩn tắc (μ = 0, σ = 1):
Z = (x − μ) / σ
Z cho biết giá trị x cách trung bình bao nhiêu độ lệch chuẩn. Từ Z, tra bảng chuẩn (hoặc dùng Excel) để ra xác suất. Một vài mốc hay dùng: P(Z > 1,5) ≈ 6,68%; P(Z > 2) ≈ 2,28%; P(Z > 2,5) ≈ 0,62%; P(Z > 3) ≈ 0,135%.
Vì x, μ, σ cùng đơn vị (mm, gam, giây…) nên Z không có đơn vị – đơn vị của nó chính là “số độ lệch chuẩn”. Nhờ vậy ta so được hai đặc tính khác hẳn nhau trên cùng một thang, ví dụ một trục lệch +2,1σ “bất thường” hơn một tấm lệch +1,4σ.
Bảng giá trị Z hay dùng ngược (biết xác suất, tìm Z):
| Xác suất tích luỹ P(Z ≤ z) | z | Dùng ở đâu |
|---|---|---|
| 0,90 | 1,282 | Một phía 10%; power 90% |
| 0,95 | 1,645 | Một phía 5%; CI hai phía 90% |
| 0,975 | 1,960 | CI hai phía 95% |
| 0,99 | 2,326 | Một phía 1% |
| 0,995 | 2,576 | CI hai phía 99% |
| 0,9995 | 3,291 | CI hai phía 99,9% |
Cẩn thận nhầm một phía/hai phía: 2,326 là ngưỡng một phía 1%, còn khoảng hai phía 99% phải dùng 2,576 – nhiều tài liệu tóm tắt ghi lẫn hai giá trị này.
Ví dụ: ước lượng phế phẩm đường kính trục (minh hoạ)
Một nhà máy cơ khí ở Đồng Nai tiện trục có dung sai 20,00 ± 0,05 mm. Dữ liệu 100 trục từ quá trình ổn định cho x̄ = 20,00 mm, s = 0,02 mm, kiểm định chuẩn đạt.
Bước 1 – Tính Z cho hai giới hạn: Z_USL = (20,05 − 20,00) / 0,02 = 2,5; Z_LSL = (19,95 − 20,00) / 0,02 = −2,5.
Bước 2 – Tra xác suất mỗi đuôi: P(Z > 2,5) ≈ 0,0062.
Bước 3 – Tổng phế phẩm dự kiến: 2 × 0,0062 ≈ 1,24%, tức khoảng 12.400 ppm.
Bước 4 – Diễn giải: khoảng cách từ trung bình tới mỗi giới hạn chỉ 2,5σ, nên Cpk = 2,5 / 3 ≈ 0,83 – chưa đạt yêu cầu thông thường 1,33. Muốn đạt 1,33 cần σ ≤ 0,05 / 4 = 0,0125 mm.
Thêm một câu hỏi: tỷ lệ trục lớn hơn 20,03 mm? Z = 0,03 / 0,02 = 1,5 → ≈ 6,7%.
Lưu ý: dự báo ppm ở đuôi rất nhạy với giả định chuẩn. Nếu thực tế đuôi dày hơn, ppm thật có thể lớn gấp nhiều lần.
Kiểm định chuẩn: làm sao biết dữ liệu có chuẩn?
Luôn kết hợp nhìn và kiểm định:
| Công cụ | Cách đọc |
|---|---|
| Histogram | Hình chuông, một đỉnh, gần đối xứng? Hai đỉnh → nghi trộn hai nguồn (2 máy, 2 khuôn) |
| Đồ thị xác suất chuẩn (normal probability plot) | Điểm bám sát đường thẳng → gần chuẩn; cong chữ S, cong một đầu → lệch hoặc đuôi bất thường |
| Anderson-Darling (AD) | H0: dữ liệu chuẩn. p ≥ 0,05 → chưa có bằng chứng bác bỏ chuẩn; p < 0,05 → không chuẩn. AD nhạy ở vùng đuôi – vùng quan trọng khi tính ppm |
| Ryan-Joiner, Kolmogorov-Smirnov | Phương án khác trong Minitab; Ryan-Joiner tương tự Shapiro-Wilk |
Hai điều cần nhớ: (1) p ≥ 0,05 không chứng minh dữ liệu chuẩn, chỉ là không đủ bằng chứng để bác bỏ; (2) với n rất lớn (vài nghìn), kiểm định bác bỏ cả những lệch rất nhỏ không có ý nghĩa thực tế – khi đó hãy nhìn đồ thị xác suất. Ngược lại với n nhỏ (< 20), kiểm định gần như không phát hiện được gì.
Một lỗi tinh vi: dữ liệu bị làm tròn quá thô (thước chỉ đọc 0,01 mm cho dung sai 0,02 mm) tạo ra các bậc thang trên đồ thị xác suất và làm AD báo không chuẩn. Đó là vấn đề độ phân giải hệ đo, không phải quá trình.
Một trường hợp hay gặp ở kiểm tra đầu vào: dữ liệu lấy sau khi đã kiểm 100% và loại hàng ngoài dung sai cho histogram bị cắt cụt hai đầu và AD báo không chuẩn. Phân phối thật của quá trình nhà cung cấp vẫn có thể chuẩn, chỉ là phần đuôi đã bị gạt đi – đừng dùng loại dữ liệu này để tính Cpk hay ppm.
Dữ liệu không chuẩn: xử lý thế nào?
Đừng vội biến đổi. Làm theo thứ tự:
- Tìm nguyên nhân trước: có điểm ngoại lai do ghi chép sai? Có trộn nhiều máy/khuôn/ca? Quá trình có ổn định không (xem biểu đồ kiểm soát)? Phân tầng rồi kiểm tra lại từng nhóm.
- Chấp nhận bản chất không chuẩn: một số đặc tính vốn lệch – độ đảo, độ phẳng, độ nhám, lực rút, thời gian sửa chữa (bị chặn ở 0). Khi đó chọn phân phối phù hợp (Weibull, lognormal, gamma…) bằng Individual Distribution Identification và tính năng lực theo phân phối đó.
- Biến đổi dữ liệu: Box-Cox (lũy thừa λ, cần dữ liệu dương) hoặc Johnson. Nhớ biến đổi cả giới hạn dung sai theo cùng cách.
- Dùng phương pháp không phụ thuộc phân phối: so sánh trung vị bằng kiểm định phi tham số thay cho t-test.
- Dựa vào định lý giới hạn trung tâm: khi phân tích trung bình của mẫu đủ lớn (t-test, Xbar chart), lệch chuẩn vừa phải thường không gây vấn đề lớn.
Làm trong Excel và Minitab
Excel:
| Mục đích | Hàm |
|---|---|
| Xác suất X ≤ x | =NORM.DIST(x; μ; σ; TRUE) |
| Xác suất Z ≤ z | =NORM.S.DIST(z; TRUE) |
| Giá trị ứng với xác suất | =NORM.INV(p; μ; σ) / =NORM.S.INV(p) |
| Z-score | =STANDARDIZE(x; μ; σ) |
| Ví dụ trên | =1-NORM.DIST(20,05;20;0,02;TRUE)+NORM.DIST(19,95;20;0,02;TRUE) ≈ 0,0124 |
Excel không có sẵn kiểm định Anderson-Darling; có thể tự vẽ đồ thị xác suất bằng cách xếp dữ liệu và so với NORM.S.INV((i-0,5)/n).
Minitab:
- Kiểm định chuẩn: Stat → Basic Statistics → Normality Test (chọn Anderson-Darling).
- Đồ thị xác suất: Graph → Probability Plot.
- Tính xác suất: Calc → Probability Distributions → Normal (Cumulative probability / Inverse).
- Tìm phân phối phù hợp: Stat → Quality Tools → Individual Distribution Identification.
- Năng lực cho dữ liệu không chuẩn: Stat → Quality Tools → Capability Analysis → Nonnormal.
Lỗi thường gặp
- Tính Cpk và ppm mà không kiểm tra chuẩn.
- Coi “p > 0,05” là bằng chứng dữ liệu chắc chắn chuẩn.
- Biến đổi Box-Cox để “cho đạt” trong khi nguyên nhân thật là trộn hai quá trình.
- Kiểm tra chuẩn khi quá trình chưa ổn định – phân phối của một quá trình đang trôi không có ý nghĩa.
- Xoá điểm ngoại lai mà không điều tra nguyên nhân.
Câu hỏi thường gặp
Biểu đồ kiểm soát có bắt buộc dữ liệu chuẩn không? Biểu đồ Xbar khá bền với lệch chuẩn nhờ lấy trung bình nhóm con. Biểu đồ giá trị cá thể (I-MR) nhạy hơn, nên kiểm tra phân phối trước.
Kiểm định nào cho dữ liệu không chuẩn? Mann-Whitney thay 2-sample t, Kruskal-Wallis thay ANOVA một yếu tố – xem kiểm định phi tham số và ANOVA một yếu tố.
Bao nhiêu điểm thì kiểm định chuẩn có ý nghĩa? Thường từ 30 điểm trở lên; dưới 20 điểm, kết quả rất yếu.
Bước tiếp theo
- Ôn lại cách tính x̄, s: Thống kê mô tả.
- Ứng dụng trực tiếp: Nghiên cứu năng lực quá trình, Cpk và SPC.
- Hiểu vì sao trung bình mẫu gần chuẩn: Định lý giới hạn trung tâm.