Industrial Knowledge
Định lý giới hạn trung tâm là gì? Sai số chuẩn và biểu đồ Xbar | Ví dụ
Nội dung bài viết 9 mục
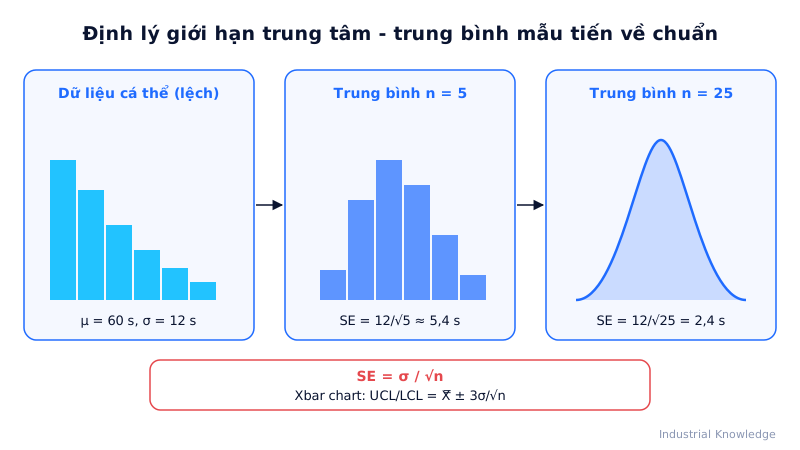
Thời gian chu kỳ của một công đoạn lắp ráp thường lệch phải, có lúc vọt lên rất cao. Vậy mà khi lấy trung bình mỗi 5 sản phẩm rồi vẽ biểu đồ, các điểm lại xếp thành hình chuông khá đẹp. Không phải phép màu – đó là định lý giới hạn trung tâm, nền tảng giải thích vì sao t-test, khoảng tin cậy và biểu đồ Xbar hoạt động được ngay cả khi dữ liệu gốc không hoàn toàn chuẩn.
Tóm tắt nhanh
- CLT: phân phối của trung bình mẫu có trung bình μ, độ lệch chuẩn σ/√n và tiến gần phân phối chuẩn khi n tăng.
- Sai số chuẩn SE = σ/√n; khi chưa biết σ ước lượng SE ≈ s/√n.
- Hai ý đầu đúng với mọi n; chỉ việc tiến gần phân phối chuẩn mới cần n đủ lớn.
- Đây là lý do t-test, khoảng tin cậy và biểu đồ Xbar dùng được cả khi dữ liệu gốc không hoàn toàn chuẩn.
Định lý giới hạn trung tâm là gì?
Định lý giới hạn trung tâm (Central Limit Theorem – CLT) phát biểu: nếu lấy nhiều mẫu ngẫu nhiên, độc lập, cỡ n từ một tổng thể có trung bình μ và độ lệch chuẩn σ hữu hạn, thì phân phối của các trung bình mẫu x̄:
- Có trung bình bằng μ (trung bình mẫu không chệch);
- Có độ lệch chuẩn bằng σ / √n – gọi là sai số chuẩn (standard error, SE);
- Tiến gần phân phối chuẩn khi n tăng, bất kể hình dạng phân phối gốc.
Ba ý trên cần tách bạch: ý 1 và 2 đúng với mọi n; chỉ ý 3 cần n “đủ lớn”.
Công thức và quy tắc ngón tay
| Đại lượng | Công thức | Ý nghĩa |
|---|---|---|
| Trung bình của x̄ | μ_x̄ = μ | Trung bình mẫu dao động quanh giá trị thật |
| Sai số chuẩn | SE = σ / √n | Độ dao động của trung bình mẫu |
| Ước lượng SE từ mẫu | SE ≈ s / √n | Dùng khi chưa biết σ |
| Z cho trung bình | Z = (x̄ − μ) / (σ / √n) | Cơ sở của khoảng tin cậy, kiểm định |
n bao nhiêu là đủ?
| Phân phối gốc | n cần để x̄ gần chuẩn |
|---|---|
| Đã gần chuẩn | Bất kỳ, kể cả n = 2–5 |
| Lệch vừa, một đỉnh | Khoảng 5–30 |
| Lệch mạnh, đuôi dài (thời gian sửa chữa, số lỗi hiếm) | 30 trở lên, đôi khi hơn nhiều |
Quy tắc “n ≥ 30” hay nghe chỉ là quy ước gần đúng, không phải định luật.
Hệ quả quan trọng của √n: muốn sai số chuẩn giảm một nửa, phải tăng cỡ mẫu lên 4 lần. Đây là lý do tăng mẫu từ 100 lên 400 thì độ chính xác chỉ cải thiện gấp đôi, và là gốc của các công thức xác định cỡ mẫu.
Phân phối mẫu: trung bình mẫu và tỷ lệ mẫu
Trước CLT cần một khái niệm: phân phối mẫu (sampling distribution) là phân phối xác suất của một trị thống kê (x̄, p̂, s…) nếu ta lấy đi lấy lại rất nhiều mẫu cùng cỡ n. Tham số tổng thể (μ, σ, p) là hằng số ta không biết; trị thống kê mẫu thay đổi theo từng lần lấy mẫu, và phân phối mẫu mô tả nó “nhảy” bao xa quanh tham số.
| Trị thống kê | Trung bình phân phối mẫu | Sai số chuẩn | Gần chuẩn khi |
|---|---|---|---|
| Trung bình mẫu x̄ | μ | σ / √n | Tổng thể chuẩn, hoặc n đủ lớn |
| Tỷ lệ mẫu p̂ | p | √[p(1 − p) / n] | n·p ≥ 10 và n·(1 − p) ≥ 10 |
Hiệu chỉnh tổng thể hữu hạn: công thức σ/√n giả định tổng thể vô hạn (một quá trình chạy liên tục) hoặc lấy mẫu có hoàn lại. Khi rút mẫu không hoàn lại từ một lô hữu hạn N và n chiếm hơn khoảng 5% lô, nhân SE với hệ số √[(N − n) / (N − 1)]. Ví dụ lấy 50 trong lô 200 chi tiết: hệ số = √(150/199) ≈ 0,87, tức SE nhỏ hơn 13%.
Điều kiện ngầm của CLT ít được nhắc: mẫu phải ngẫu nhiên và độc lập. Lấy 5 sản phẩm liên tiếp cùng một khuôn là hợp lệ cho nhóm con của biểu đồ kiểm soát (mục đích chính là đo biến động ngắn hạn), nhưng không phải mẫu ngẫu nhiên đại diện cho cả ca.
Ví dụ: thời gian chu kỳ công đoạn lắp ráp (minh hoạ)
Một nhà máy điện tử ở Bắc Ninh đo thời gian chu kỳ công đoạn bắt vít. Dữ liệu cá thể lệch phải, trung bình dài hạn μ ≈ 60 giây, σ ≈ 12 giây.
Câu hỏi 1 – Trung bình 5 sản phẩm dao động bao nhiêu? SE = 12 / √5 = 12 / 2,236 ≈ 5,37 giây.
Câu hỏi 2 – Trung bình 25 sản phẩm? SE = 12 / √25 = 12 / 5 = 2,4 giây. Cỡ mẫu tăng 5 lần, SE giảm √5 ≈ 2,24 lần.
Câu hỏi 3 – Xác suất trung bình 25 sản phẩm vượt 65 giây? Z = (65 − 60) / 2,4 ≈ 2,08 → P(Z > 2,08) ≈ 1,9%. Nếu một ca có trung bình 25 sản phẩm là 65 giây, rất có thể có nguyên nhân đặc biệt (vít mới, người mới) chứ không chỉ do ngẫu nhiên.
So sánh: xác suất một sản phẩm đơn lẻ vượt 65 giây là khá lớn (chỉ cách 0,42σ). Trung bình “lọc” nhiễu ngẫu nhiên và làm thay đổi thật dễ thấy hơn.
Liên hệ với biểu đồ Xbar
Biểu đồ Xbar theo dõi trung bình nhóm con, nên giới hạn kiểm soát dùng sai số chuẩn chứ không dùng σ cá thể:
UCL / LCL = X̿ ± 3 × σ / √n
Với ví dụ trên, nhóm con n = 4: σ/√4 = 6 giây → UCL = 60 + 18 = 78 giây, LCL = 60 − 18 = 42 giây.
Trong thực tế σ được ước lượng từ range trung bình: σ̂ = R̄ / d₂. Hằng số A₂ trong biểu đồ Xbar-R chính là 3 / (d₂ × √n) – ví dụ n = 5: d₂ = 2,326 → A₂ = 3 / (2,326 × 2,236) ≈ 0,577. Nói cách khác, A₂ đã “đóng gói” định lý giới hạn trung tâm vào bảng hằng số.
Ba hệ quả thực tế:
- Giới hạn kiểm soát Xbar hẹp hơn phân bố sản phẩm – không được vẽ dung sai lên biểu đồ Xbar để so sánh.
- Nhóm con lớn hơn → giới hạn hẹp hơn → phát hiện dịch chuyển nhỏ nhanh hơn.
- Nhờ CLT, Xbar chart khá bền khi dữ liệu cá thể hơi lệch; biểu đồ I-MR thì không có “lá chắn” này.
Xem thêm nguyên lý chung tại biểu đồ kiểm soát.
Làm trong Excel và Minitab
Excel:
- Sai số chuẩn:
=STDEV.S(A2:A101)/SQRT(COUNT(A2:A101)). - Mô phỏng CLT: tạo dữ liệu lệch bằng
=-60*LN(RAND())(phân phối mũ, trung bình 60) cho 5 cột, rồi=AVERAGE(B2:F2)từng dòng; vẽ histogram (Insert → Chart → Histogram) cột gốc và cột trung bình để thấy hình dạng thay đổi. - Xác suất cho trung bình:
=1-NORM.DIST(65;60;12/SQRT(25);TRUE).
Minitab:
- Tạo dữ liệu mô phỏng: Calc → Random Data → Exponential (hoặc phân phối khác), nhiều cột.
- Tính trung bình theo dòng: Calc → Row Statistics → Mean.
- So sánh hình dạng: Graph → Histogram hoặc Stat → Basic Statistics → Graphical Summary.
- Biểu đồ Xbar: Stat → Control Charts → Variables Charts for Subgroups → Xbar-R.
Lỗi thường gặp
- Nghĩ CLT làm dữ liệu gốc thành chuẩn. Không – chỉ phân phối của trung bình mới gần chuẩn. Tỷ lệ phế phẩm, Cpk vẫn phải xét theo phân phối cá thể.
- Áp dụng với mẫu không độc lập (đo liên tiếp có tự tương quan, mẫu lấy cùng một khuôn). SE thật lớn hơn σ/√n.
- Nhầm σ và SE khi báo cáo: “độ lệch chuẩn 2,4 giây” trong khi đó là sai số chuẩn của trung bình.
- Tin quy tắc n ≥ 30 tuyệt đối với dữ liệu cực lệch hoặc tỷ lệ lỗi rất thấp.
- So sánh điểm Xbar với dung sai – sai đơn vị so sánh.
Câu hỏi thường gặp
CLT có áp dụng cho tỷ lệ lỗi không? Có: tỷ lệ mẫu p̂ là trung bình của các giá trị 0/1, nên gần chuẩn khi n·p và n·(1 − p) đều đủ lớn (thường ≥ 10). Đó là cơ sở của khoảng tin cậy cho tỷ lệ.
Vì sao biểu đồ Xbar thường dùng n = 4 hoặc 5? Đủ để trung bình gần chuẩn và nhạy với dịch chuyển, nhưng vẫn nhỏ để nhóm con lấy trong thời gian ngắn, chỉ chứa biến động ngẫu nhiên.
CLT liên quan gì đến t-test? t-test so sánh trung bình; CLT đảm bảo trung bình gần chuẩn khi n vừa đủ, nên t-test chịu được lệch chuẩn vừa phải.
Bước tiếp theo
- Dùng SE để ước lượng: Khoảng tin cậy.
- Tính cần bao nhiêu mẫu: Xác định cỡ mẫu.
- Ôn phân phối chuẩn: Phân phối chuẩn và kiểm định chuẩn.