Industrial Knowledge
Bài toán phân loại: Logistic, Naive Bayes, KNN, SVM, Cây quyết định, Random Forest, Boosting
Nội dung bài viết 9 mục
Tóm tắt nhanh
- Phân loại dự đoán nhãn: Đạt/Không đạt, Hỏng/Không hỏng, nhóm lỗi A/B/C.
- Bắt đầu bằng mô hình đơn giản, dễ giải thích (Logistic, Cây quyết định), rồi mới thử mô hình mạnh hơn (Random Forest, Boosting).
- Không dùng “độ chính xác” (accuracy) khi dữ liệu mất cân bằng — sản phẩm lỗi thường chỉ 1–3%.
- Chọn ngưỡng dự đoán theo chi phí: bỏ sót lỗi tốn hơn hay báo động giả tốn hơn?
Bài toán ví dụ
Từ dữ liệu 20.000 lần ép với các thông số quá trình (nhiệt độ, áp suất, thời gian chu kỳ, nhiệt độ môi trường, khuôn, ca) và kết quả kiểm tra, xây mô hình cảnh báo lần ép có nguy cơ cho sản phẩm lỗi để kiểm tra tăng cường.
Các thuật toán phân loại
| Thuật toán | Nguyên lý ngắn gọn | Ưu điểm | Hạn chế |
|---|---|---|---|
| Logistic Regression | Ước lượng xác suất qua hàm sigmoid của tổ hợp tuyến tính các biến | Nhanh, dễ giải thích hệ số | Khó bắt quan hệ phi tuyến |
| Naive Bayes | Định lý Bayes, giả định các biến độc lập | Rất nhanh, ít dữ liệu vẫn chạy | Giả định độc lập hiếm khi đúng |
| KNN | Gán nhãn theo K điểm gần nhất | Đơn giản, không cần huấn luyện | Chậm khi dữ liệu lớn, cần chuẩn hoá thang đo |
| SVM | Tìm đường biên phân tách rộng nhất giữa các lớp | Tốt với dữ liệu nhiều chiều | Khó giải thích, chậm khi dữ liệu lớn |
| Cây quyết định | Chia dữ liệu bằng chuỗi câu hỏi “nếu… thì…” | Dễ hiểu, vẽ ra được | Dễ quá khớp, kém ổn định |
| Random Forest | Trung bình nhiều cây trên mẫu ngẫu nhiên (bagging) | Chính xác, ổn định, cho độ quan trọng biến | Kém trực quan hơn một cây |
| Boosting (XGBoost, LightGBM) | Cây sau sửa sai cho cây trước | Thường chính xác nhất với dữ liệu bảng | Nhiều tham số, dễ quá khớp nếu không kiểm soát |
Cây quyết định – dễ giải thích nhất
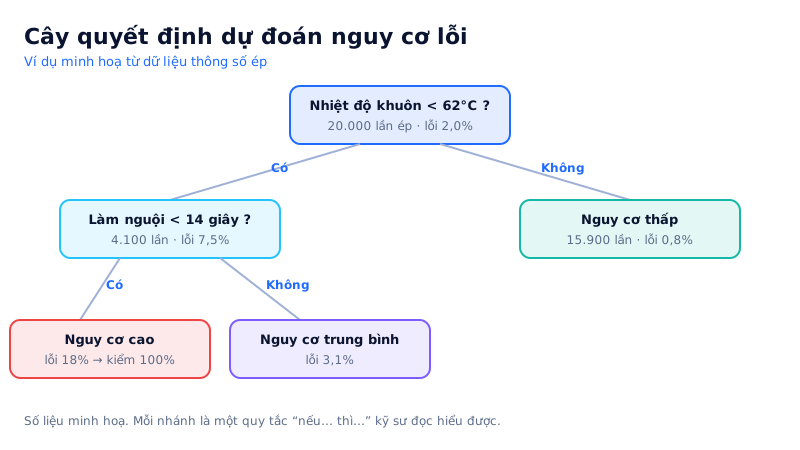
Một cây sâu 3 tầng có thể cho ra quy tắc như:
- Nếu nhiệt độ khuôn < 62°C và thời gian làm nguội < 14 giây → nguy cơ lỗi cao (18%)
- Nếu nhiệt độ khuôn ≥ 62°C → nguy cơ thấp (0,8%)
Quy tắc dạng này kỹ sư hiểu ngay, có thể đưa vào Control Plan hoặc thiết kế Poka-yoke.
Ma trận nhầm lẫn và các chỉ số
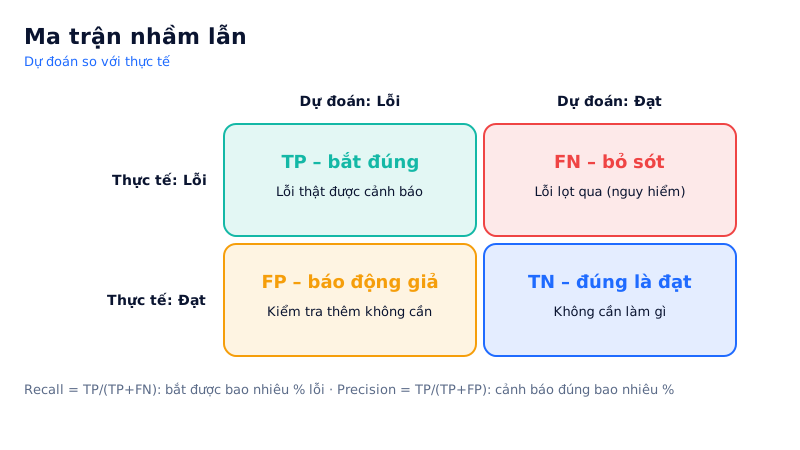
| Dự đoán: Lỗi | Dự đoán: Đạt | |
|---|---|---|
| Thực tế: Lỗi | TP – bắt đúng | FN – bỏ sót |
| Thực tế: Đạt | FP – báo động giả | TN – đúng là đạt |
| Chỉ số | Công thức | Câu hỏi trả lời |
|---|---|---|
| Accuracy | (TP + TN) / Tổng | Đúng bao nhiêu % tổng thể |
| Precision | TP / (TP + FP) | Trong các cảnh báo, bao nhiêu % là lỗi thật |
| Recall | TP / (TP + FN) | Trong các lỗi thật, bắt được bao nhiêu % |
| F1 | Trung bình điều hoà Precision và Recall | Cân bằng hai chỉ số trên |
| ROC-AUC | Diện tích dưới đường ROC | Khả năng xếp hạng lỗi cao hơn đạt, không phụ thuộc ngưỡng |
Vì sao accuracy đánh lừa? Nếu chỉ 2% sản phẩm lỗi, mô hình “luôn đoán Đạt” có accuracy 98% nhưng không bắt được lỗi nào (recall = 0). Cách nghĩ này tương tự sai lầm loại I/loại II trong kiểm định giả thuyết và đánh giá hệ thống đo thuộc tính.
Code Python (Random Forest)
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, confusion_matrix

X = pd.get_dummies(df.drop(columns="loi"), columns=["khuon", "ca"])
y = df["loi"]                      # 1 = lỗi, 0 = đạt

X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=1)

rf = RandomForestClassifier(n_estimators=300, class_weight="balanced",
                            min_samples_leaf=5, random_state=1)
rf.fit(X_tr, y_tr)

proba = rf.predict_proba(X_te)[:, 1]
pred = (proba >= 0.3).astype(int)  # ngưỡng thấp hơn 0.5 để tăng recall
print(confusion_matrix(y_te, pred))
print(classification_report(y_te, pred, digits=3))

imp = pd.Series(rf.feature_importances_, X.columns).sort_values(ascending=False)
print(imp.head(10))
Xử lý dữ liệu mất cân bằng
stratify=ykhi chia dữ liệu để tỉ lệ lỗi giống nhau ở hai tập.class_weight="balanced"để mô hình coi trọng lớp hiếm.- Hạ ngưỡng quyết định (0,5 → 0,3) để tăng recall, chấp nhận thêm báo động giả.
- Lấy mẫu lại (oversampling lớp lỗi, undersampling lớp đạt) — chỉ áp dụng trên tập huấn luyện.
Chọn ngưỡng theo chi phí
| Tình huống | Ưu tiên |
|---|---|
| Lỗi lọt đến khách gây khiếu nại, thu hồi | Recall cao (bắt hết lỗi), chấp nhận kiểm tra thêm |
| Kiểm tra lại tốn kém, phá huỷ mẫu | Precision cao (cảnh báo phải đúng) |
Lỗi hay gặp
- Rò rỉ dữ liệu: đưa vào biến chỉ biết sau khi kiểm tra (ví dụ “mã lỗi”) → mô hình đẹp trên giấy, vô dụng thực tế.
- Chia ngẫu nhiên khi dữ liệu có thứ tự thời gian → nên kiểm tra trên giai đoạn sau.
- Không theo dõi mô hình sau khi đổi khuôn, vật liệu.
Cần người làm giúp?
Industrial Knowledge hỗ trợ phân tích dữ liệu quá trình, xây mô hình cảnh báo lỗi và dashboard theo dõi. Xem dịch vụ.