Industrial Knowledge
Python cho phân tích dữ liệu: pandas cơ bản với dữ liệu sản xuất | Ví dụ code
Nội dung bài viết 11 mục
Tóm tắt nhanh
- Python là ngôn ngữ lập trình miễn phí, phổ biến nhất cho phân tích dữ liệu; pandas là thư viện xử lý bảng dữ liệu.
- Python mạnh khi: dữ liệu lớn, nhiều file, việc lặp lại, cần thống kê/học máy.
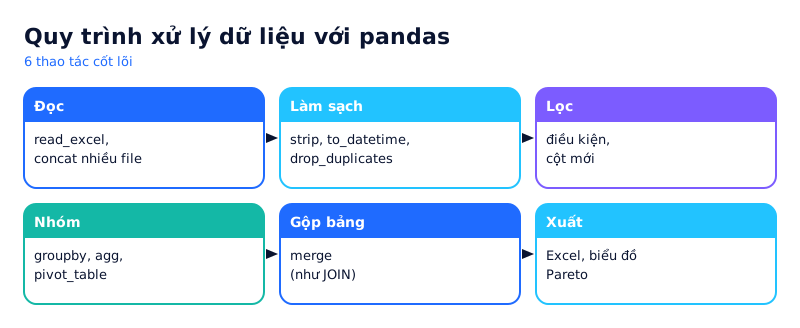
- 6 thao tác cốt lõi: đọc – làm sạch – lọc – nhóm (groupby) – gộp bảng (merge) – xuất kết quả.
- Không thay thế Excel/Power BI mà bổ sung: Python xử lý, Excel/Power BI trình bày.
Khi nào nên dùng Python thay vì Excel?
| Tình huống | Excel | Python |
|---|---|---|
| Vài nghìn dòng, phân tích một lần | Phù hợp | Không cần |
| Gộp 200 file log máy mỗi tuần | Chậm, dễ sai | Vài giây, lặp lại được |
| Hàng triệu dòng dữ liệu cảm biến | Quá giới hạn | Phù hợp |
| Thống kê nâng cao, học máy | Hạn chế | Thư viện đầy đủ (scipy, scikit-learn) |
| Người xem cuối là lãnh đạo | Phù hợp | Xuất ra Excel/Power BI |
Chuẩn bị
Cài Anaconda (đã có sẵn Python, pandas, Jupyter Notebook) hoặc dùng Google Colab miễn phí trên trình duyệt. Jupyter Notebook cho phép chạy từng đoạn code và xem kết quả ngay — rất hợp để khám phá dữ liệu.
1. Đọc dữ liệu
import pandas as pd
from pathlib import Path

# Đọc một file
df = pd.read_excel("kiem_tra_2026_10.xlsx", sheet_name="Data")

# Gộp tất cả file trong thư mục
files = Path("bao_cao_loi").glob("*.xlsx")
df = pd.concat([pd.read_excel(f).assign(nguon=f.name) for f in files],
               ignore_index=True)

df.head()      # 5 dòng đầu
df.info()      # kiểu dữ liệu, số ô trống
df.describe()  # thống kê mô tả
2. Làm sạch
df.columns = df.columns.str.strip().str.lower()       # tên cột gọn
df["day_chuyen"] = df["day_chuyen"].str.strip().str.upper()
df["ngay"] = pd.to_datetime(df["ngay"], dayfirst=True, errors="coerce")
df = df.drop_duplicates(subset=["so_phieu"])          # bỏ phiếu trùng
df["so_loi"] = df["so_loi"].fillna(0)
print(df["ngay"].isna().sum(), "dòng ngày không hợp lệ")
3. Lọc và tính cột mới
thang10 = df[(df["ngay"] >= "2026-10-01") & (df["ngay"] < "2026-11-01")]
df["ti_le_loi"] = df["so_loi"] / df["so_kiem"]
df["thang"] = df["ngay"].dt.to_period("M")
4. Nhóm và tổng hợp (groupby)
theo_dc = (df.groupby("day_chuyen")
             .agg(so_kiem=("so_kiem", "sum"), so_loi=("so_loi", "sum"))
             .assign(ti_le=lambda x: x.so_loi / x.so_kiem)
             .sort_values("ti_le", ascending=False))

bang_thang = df.pivot_table(index="thang", columns="day_chuyen",
                            values="so_loi", aggfunc="sum", fill_value=0)
Lưu ý: tỉ lệ lỗi phải tính bằng tổng lỗi / tổng kiểm, không lấy trung bình của cột tỉ lệ.
5. Gộp bảng (merge)
sp = pd.read_excel("danh_muc_san_pham.xlsx")   # ma_sp, ten_sp, khach_hang
df = df.merge(sp, on="ma_sp", how="left")
print(df["ten_sp"].isna().sum(), "dòng không tìm thấy mã sản phẩm")
how="left" tương đương LEFT JOIN trong SQL.
6. Vẽ Pareto và xuất báo cáo
import matplotlib.pyplot as plt

p = df.groupby("ma_loi")["so_loi"].sum().sort_values(ascending=False)
cum = p.cumsum() / p.sum() * 100

fig, ax = plt.subplots(figsize=(9, 4))
ax.bar(p.index, p.values)
ax2 = ax.twinx(); ax2.plot(p.index, cum.values, marker="o", color="red")
ax2.axhline(80, ls="--", color="gray"); ax2.set_ylim(0, 105)
plt.title("Pareto lỗi tháng 10"); plt.tight_layout()
plt.savefig("pareto.png", dpi=150)

with pd.ExcelWriter("bao_cao.xlsx") as w:
    theo_dc.to_excel(w, sheet_name="Theo day chuyen")
    bang_thang.to_excel(w, sheet_name="Theo thang")
Xem cách đọc biểu đồ tại Pareto chart.
Các thư viện nên biết
| Thư viện | Dùng để |
|---|---|
| pandas | Xử lý bảng dữ liệu |
| numpy | Tính toán số học |
| matplotlib, seaborn, plotly | Vẽ biểu đồ |
| scipy, statsmodels | Kiểm định thống kê, hồi quy |
| scikit-learn | Học máy |
| openpyxl | Đọc ghi Excel, định dạng |
Lỗi hay gặp
- Ngày bị đảo ngày/tháng vì không đặt
dayfirst=True. - Gộp bảng với danh mục có mã trùng → số dòng tăng bất thường; kiểm tra
len(df)trước và sau merge. - Sửa dữ liệu trong notebook rồi quên lưu lại các bước → không lặp lại được.
Cần người làm giúp?
Industrial Knowledge viết script Python gộp, làm sạch dữ liệu và xuất báo cáo tự động theo quy trình riêng của nhà máy. Xem dịch vụ.