Industrial Knowledge
Phân cụm K-Means và luật kết hợp Apriori: tìm nhóm và mối liên hệ ẩn trong dữ liệu
Nội dung bài viết 13 mục
Tóm tắt nhanh
- K-Means chia đối tượng thành K nhóm giống nhau mà không cần nhãn có sẵn.
- Apriori tìm luật “nếu có A thì thường có B” trong dữ liệu giao dịch.
- Đây là học không giám sát: không có đáp án đúng, kết quả cần người hiểu nghiệp vụ đặt tên và kiểm chứng.
- Chuẩn hoá thang đo trước K-Means; lọc luật Apriori theo Lift > 1 và đủ Support.
Phần 1 – K-Means
Ý tưởng
- Chọn K tâm cụm ban đầu.
- Gán mỗi điểm vào tâm gần nhất.
- Tính lại tâm cụm là trung bình các điểm trong cụm.
- Lặp bước 2–3 đến khi các cụm không đổi.
Ví dụ: phân cụm nhà cung cấp
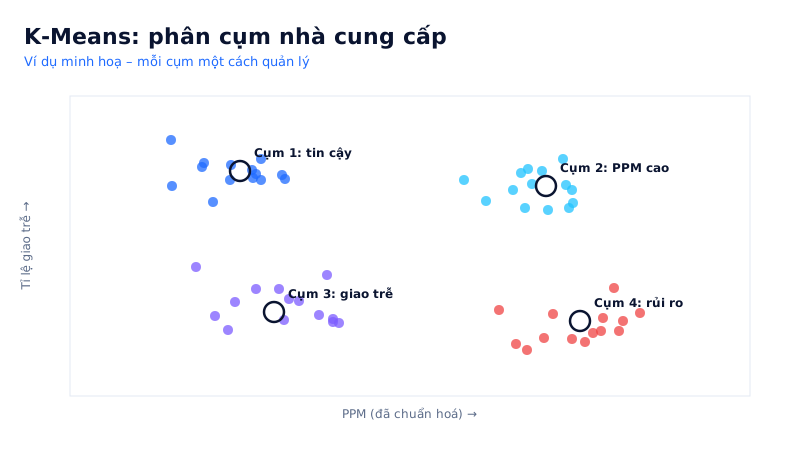
Mỗi nhà cung cấp có 4 chỉ số trung bình năm: tỉ lệ giao đúng hạn, PPM, thời gian phản hồi khiếu nại, biến động giá. K-Means có thể tách thành các nhóm như:
| Cụm | Đặc điểm | Hành động gợi ý |
|---|---|---|
| 1 | Giao đúng hạn cao, PPM thấp | Đối tác chiến lược, giảm tần suất kiểm tra đầu vào |
| 2 | Giao đúng hạn tốt, PPM cao | Yêu cầu 8D, đánh giá quá trình |
| 3 | Giao trễ, PPM thấp | Làm việc về năng lực, kế hoạch giao hàng |
| 4 | Giao trễ, PPM cao | Kế hoạch cải tiến hoặc tìm nguồn thay thế |
Kết hợp với scorecard nhà cung cấp và đánh giá quá trình VDA 6.3.
Code Python
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score

cols = ["otd", "ppm", "tg_phan_hoi", "bien_dong_gia"]
X = StandardScaler().fit_transform(ncc[cols])   # bắt buộc chuẩn hoá

for k in range(2, 8):
    km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(X)
    print(k, round(km.inertia_, 1), round(silhouette_score(X, km.labels_), 3))

ncc["cum"] = KMeans(n_clusters=4, n_init=10, random_state=0).fit_predict(X)
print(ncc.groupby("cum")[cols].mean().round(2))
Chọn số cụm K
- Elbow: vẽ tổng bình phương khoảng cách trong cụm (inertia) theo K, chọn điểm “gãy khuỷu tay”.
- Silhouette: từ −1 đến 1, càng cao các cụm càng tách biệt.
- Ý nghĩa nghiệp vụ: số cụm phải đặt tên và hành động được. 4 cụm dùng được tốt hơn 9 cụm “đúng toán”.
Lưu ý
- Không chuẩn hoá → biến có thang lớn (PPM hàng nghìn) lấn át biến thang nhỏ (tỉ lệ 0–1).
- K-Means giả định cụm có dạng tròn, kích thước tương đương; nhạy với ngoại lai.
- Kết quả phụ thuộc điểm khởi tạo → đặt
n_initđủ lớn.
Phần 2 – Luật kết hợp Apriori
Ý tưởng
Từ danh sách “giao dịch” (mỗi sản phẩm lỗi có một tập mã lỗi; mỗi phiếu xuất kho có một tập vật tư), tìm các tập mục thường xuất hiện cùng nhau, rồi sinh luật A → B.
Ba chỉ số
| Chỉ số | Công thức | Ý nghĩa |
|---|---|---|
| Support | Tỉ lệ giao dịch chứa cả A và B | Luật có phổ biến không |
| Confidence | Support(A,B) / Support(A) | Khi có A, bao nhiêu % có B |
| Lift | Confidence / Support(B) | > 1: A và B đi cùng nhau nhiều hơn ngẫu nhiên |
Ví dụ: lỗi đi kèm
Luật {Bavia} → {Thiếu liệu} với Confidence 45%, Lift 3,2: sản phẩm có bavia có khả năng thiếu liệu cao gấp 3,2 lần bình thường → gợi ý chung một nguyên nhân gốc (áp suất/nhiệt độ không ổn định, khuôn mòn). Đây là đầu vào tốt cho biểu đồ xương cá và phân tích nguyên nhân gốc.
Ứng dụng khác: vật tư hay xuất cùng nhau → sắp xếp kho gần nhau; bộ phụ tùng bảo trì nên chuẩn bị theo cặp.
Code Python
from mlxtend.preprocessing import TransactionEncoder
from mlxtend.frequent_patterns import apriori, association_rules

gd = loi.groupby("ma_san_pham")["ma_loi"].apply(list).tolist()
te = TransactionEncoder()
onehot = pd.DataFrame(te.fit(gd).transform(gd), columns=te.columns_)

tap = apriori(onehot, min_support=0.02, use_colnames=True)
luat = association_rules(tap, metric="lift", min_threshold=1.2)
print(luat.sort_values("lift", ascending=False)
          [["antecedents", "consequents", "support", "confidence", "lift"]]
          .head(10))
Lưu ý
- Support quá thấp → hàng nghìn luật vô nghĩa; quá cao → bỏ lỡ luật hiếm nhưng quan trọng.
- Luật kết hợp không phải nhân quả — chỉ là gợi ý để điều tra tiếp.
Cần người làm giúp?
Industrial Knowledge hỗ trợ phân cụm nhà cung cấp, khách hàng, sản phẩm và phân tích lỗi đi kèm từ dữ liệu sẵn có. Xem dịch vụ.