Industrial Knowledge
Hồi quy tuyến tính trong phân tích dữ liệu: xây mô hình, đánh giá R², MAE, RMSE và kiểm tra giả định
Nội dung bài viết 9 mục
Tóm tắt nhanh
- Hồi quy tuyến tính dự đoán một biến số liên tục (độ bền, kích thước, sản lượng, chi phí) từ một hay nhiều biến đầu vào.
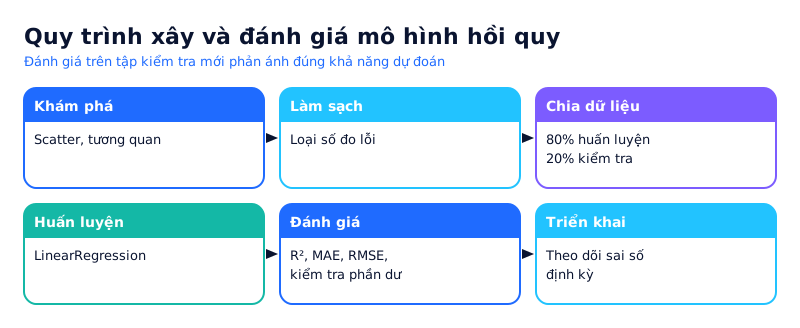
- Luôn chia dữ liệu thành tập huấn luyện và kiểm tra; đánh giá trên tập kiểm tra mới phản ánh đúng khả năng dự đoán.
- Chỉ số đánh giá: R² (giải thích được bao nhiêu biến động), MAE/RMSE (sai số trung bình theo đơn vị gốc), MAPE (sai số %).
- Kiểm tra phần dư và đa cộng tuyến trước khi tin vào hệ số.
Kiến thức nền về hồi quy xem tại Hồi quy cơ bản; bài này tập trung vào quy trình xây và đánh giá mô hình dự báo.
Bài toán ví dụ
Dự đoán độ bền kéo của sản phẩm ép nhựa từ: nhiệt độ khuôn, áp suất phun, thời gian làm nguội, độ ẩm hạt nhựa. Có 600 mẫu lịch sử đã đo.
Quy trình 6 bước
- Khám phá dữ liệu: thống kê mô tả, biểu đồ scatter từng biến với độ bền, hệ số tương quan.
- Làm sạch: loại giá trị đo lỗi, xử lý thiếu.
- Chia dữ liệu: 80% huấn luyện, 20% kiểm tra (ngẫu nhiên, hoặc theo thời gian nếu dữ liệu có thứ tự thời gian).
- Huấn luyện mô hình trên tập huấn luyện.
- Đánh giá trên tập kiểm tra.
- Diễn giải và triển khai: đọc hệ số, dùng mô hình chọn thông số, theo dõi sai số định kỳ.
Code Python
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score, mean_absolute_error, mean_squared_error

df = pd.read_excel("do_ben.xlsx")
X = df[["nhiet_do_khuon", "ap_suat", "tg_lam_nguoi", "do_am"]]
y = df["do_ben"]

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42)

model = LinearRegression().fit(X_train, y_train)
pred = model.predict(X_test)

print("R2  :", round(r2_score(y_test, pred), 3))
print("MAE :", round(mean_absolute_error(y_test, pred), 2))
print("RMSE:", round(mean_squared_error(y_test, pred) ** 0.5, 2))
print(dict(zip(X.columns, model.coef_.round(3))))
Đọc các chỉ số đánh giá
| Chỉ số | Ý nghĩa | Cách đọc |
|---|---|---|
| R² | Tỉ lệ biến động của Y được mô hình giải thích | 0–1, càng gần 1 càng tốt; so với R² tập huấn luyện để phát hiện quá khớp |
| R² hiệu chỉnh | R² có phạt khi thêm biến | Dùng khi so sánh mô hình có số biến khác nhau |
| MAE | Sai số tuyệt đối trung bình | Cùng đơn vị Y, dễ giải thích: “trung bình lệch 1,8 MPa” |
| RMSE | Căn bậc hai sai số bình phương trung bình | Phạt nặng sai số lớn; luôn ≥ MAE |
| MAPE | Sai số phần trăm trung bình | Dễ trao đổi với lãnh đạo; không dùng khi Y gần 0 |
So với dung sai: một mô hình có RMSE = 1,8 MPa có đủ dùng không phụ thuộc vào yêu cầu kỹ thuật. Nếu dung sai là ±2 MPa, sai số này quá lớn để thay thế phép đo.
Kiểm tra giả định
| Giả định | Cách kiểm | Nếu vi phạm |
|---|---|---|
| Quan hệ tuyến tính | Scatter phần dư theo giá trị dự đoán, không có dạng cong | Thêm biến bậc hai, biến đổi log |
| Phần dư phân phối chuẩn | Histogram, biểu đồ xác suất chuẩn | Biến đổi Y, kiểm tra ngoại lai |
| Phương sai đều | Phần dư không loe ra theo giá trị dự đoán | Biến đổi Y, hồi quy có trọng số |
| Phần dư độc lập | Không có xu hướng theo thứ tự thời gian | Mô hình chuỗi thời gian |
| Không đa cộng tuyến | VIF < 5–10 | Bỏ bớt biến tương quan cao |
Diễn giải hệ số – cẩn thận nhân quả
Hệ số +0,35 của nhiệt độ khuôn nghĩa là: khi các biến khác giữ nguyên, tăng 1°C thì độ bền dự đoán tăng 0,35 MPa — trong phạm vi dữ liệu đã có. Hồi quy trên dữ liệu lịch sử cho thấy liên hệ, chưa chứng minh nhân quả. Muốn khẳng định và tối ưu thông số, nên thiết kế thí nghiệm DOE.
Làm trong Excel
Data → Data Analysis → Regression (bật Analysis ToolPak) cho bảng hệ số, R², p-value, phần dư. Phù hợp với mô hình nhỏ, giải thích cho người không dùng Python.
Lỗi hay gặp
- Chỉ đánh giá trên tập huấn luyện → R² đẹp nhưng dự đoán thực tế kém.
- Ngoại suy ra ngoài phạm vi dữ liệu (dự đoán ở nhiệt độ chưa từng chạy).
- Đưa quá nhiều biến khi dữ liệu ít → quá khớp.
Cần người làm giúp?
Industrial Knowledge hỗ trợ xây mô hình hồi quy, dự báo từ dữ liệu quá trình và trình bày kết quả dễ hiểu. Xem dịch vụ.