Industrial Knowledge
Dự báo và Machine Learning cơ bản trong sản xuất: hồi quy, phân loại, phân cụm, chuỗi thời gian
Nội dung bài viết 8 mục
Tóm tắt nhanh
- Machine Learning (học máy) là cách để máy tính học quy luật từ dữ liệu quá khứ để dự đoán hoặc phân nhóm.
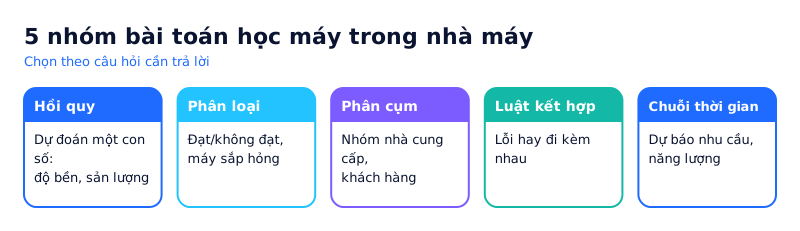
- 5 nhóm bài toán phổ biến: hồi quy (dự đoán số), phân loại (dự đoán nhãn), phân cụm, luật kết hợp, chuỗi thời gian.
- Điều kiện tiên quyết: dữ liệu đủ nhiều, sạch, và một câu hỏi kinh doanh rõ ràng.
- Đa số doanh nghiệp nên làm tốt dashboard mô tả, chẩn đoán trước khi đầu tư vào dự báo.
Học máy là gì?
Thay vì lập trình quy tắc “nếu nhiệt độ > X thì lỗi”, học máy để thuật toán tự tìm quy luật từ dữ liệu có sẵn, rồi áp dụng cho dữ liệu mới. Học máy là bước tiếp theo sau phân tích mô tả và chẩn đoán — tương ứng cấp dự báo và đề xuất trong 4 cấp độ phân tích dữ liệu.
5 nhóm bài toán và ví dụ nhà máy
| Bài toán | Câu hỏi | Ví dụ nhà máy | Thuật toán tiêu biểu |
|---|---|---|---|
| Hồi quy | Dự đoán một con số | Dự đoán độ bền kéo từ thông số quá trình | Hồi quy tuyến tính, Random Forest |
| Phân loại | Dự đoán thuộc nhóm nào | Sản phẩm đạt/không đạt; máy sắp hỏng/không | Logistic regression, Decision Tree, Naive Bayes, KNN, SVM, Boosting |
| Phân cụm | Chia nhóm khi chưa có nhãn | Nhóm nhà cung cấp theo hành vi giao hàng, chất lượng | K-Means |
| Luật kết hợp | Cái gì hay đi cùng nhau | Lỗi A thường xuất hiện cùng lỗi B; vật tư hay xuất cùng | Apriori |
| Chuỗi thời gian | Giá trị tương lai theo thời gian | Dự báo nhu cầu, sản lượng, tiêu thụ điện | Trung bình trượt, làm trơn mũ, ARIMA |
Hồi quy – điểm khởi đầu dễ nhất
Hồi quy tuyến tính đã quen thuộc với người làm Six Sigma. Có thể làm ngay trong Excel (Data Analysis ToolPak hoặc hàm LINEST). Ví dụ: tìm quan hệ giữa nhiệt độ khuôn, áp suất và kích thước sản phẩm để chọn thông số tối ưu — gần với tinh thần DOE.
Phân loại – bảo trì dự đoán, kiểm tra chất lượng
Với dữ liệu cảm biến (rung, nhiệt, dòng điện) và lịch sử hỏng hóc, mô hình phân loại có thể cảnh báo máy có nguy cơ hỏng trong 7 ngày tới. Đánh giá mô hình bằng ma trận nhầm lẫn: tỉ lệ bắt đúng (recall) và báo động giả (precision) — tương tự cách nghĩ về sai lầm loại I, loại II trong kiểm định giả thuyết.
Chuỗi thời gian – dự báo nhu cầu
Dữ liệu theo thời gian thường gồm xu hướng, mùa vụ và nhiễu. Bắt đầu từ phương pháp đơn giản (trung bình trượt, làm trơn mũ — Excel có sẵn hàm FORECAST.ETS) trước khi dùng mô hình phức tạp.
Quy trình một dự án học máy
- Xác định câu hỏi và cách đo thành công (ví dụ giảm 30% dừng máy đột xuất).
- Thu thập, làm sạch dữ liệu — vẫn chiếm phần lớn công sức.
- Chia dữ liệu huấn luyện / kiểm tra.
- Xây và so sánh vài mô hình, chọn mô hình đơn giản nhất đạt yêu cầu.
- Thử nghiệm thực tế, theo dõi độ chính xác theo thời gian.
Giới hạn cần biết
- Rác vào, rác ra: dữ liệu sai thì dự báo sai.
- Quá khớp (overfitting): mô hình thuộc lòng dữ liệu cũ, dự đoán kém dữ liệu mới.
- Thay đổi điều kiện: đổi vật liệu, khuôn, quy trình → mô hình cũ mất hiệu lực.
- Giải thích được: trong môi trường chất lượng, mô hình cần đủ dễ giải thích để kỹ sư tin và hành động.
Nếu triển khai AI trong hệ thống quản lý, tham khảo thêm ISO/IEC 42001.
Cần người làm giúp?
Industrial Knowledge hỗ trợ từ nền tảng dữ liệu, dashboard đến các mô hình dự báo đơn giản trên Excel, Power BI. Xem dịch vụ.